Les questions
Une librairie en ligne m’a confié deux ans de données de ventes, de mars 2021 à février 2023, réparties en trois fichiers : clients, produits et transactions. Deux demandes les accompagnaient.
La première venait de la direction : une vue d’ensemble de l’activité. Comment le chiffre d’affaires évolue-t-il dans le temps ? Quelles références se vendent, et lesquelles ne se vendent pas ? Comment le chiffre d’affaires se répartit-il entre les clients ?
La seconde venait de Julie, responsable marketing, avec cinq questions précises sur le comportement des clients : existe-t-il un lien entre le genre d’un client et la catégorie des livres qu’il achète ? Et entre son âge et son montant total d’achats, sa fréquence d’achat, son panier moyen et les catégories qu’il achète ?
- 11,1 M€de chiffre d’affaires sur deux ans, hors B2B
- 8 596clients
- 3 286références réparties en trois catégories
- 5tests statistiques pour le marketing
D’abord, le nettoyage
Le fichier des transactions contenait plus de 361 000 lignes entièrement vides, un artefact de l’export Excel, que j’ai supprimées. La jointure des trois fichiers sur les identifiants clients et produits a ensuite révélé 21 références jamais vendues et 21 clients n’ayant jamais rien acheté ; je les ai mis de côté, et les références jamais vendues sont revenues plus tard dans l’analyse des flops.
La décision la plus importante concernait quatre clients. Chacun d’eux comptait plus de 2 500 sessions et avait dépensé entre 114 000 € et 326 000 €, alors que le meilleur de tous les autres clients avait dépensé 5 300 €. Ce sont clairement des clients professionnels, pas des particuliers, et les conserver aurait faussé toutes les moyennes. Je les ai donc analysés à part : ensemble, ils pèsent 884 000 €, soit 7,35 % du chiffre d’affaires total, et trois références ne sont achetées que par eux.
Le chiffre d’affaires : stable et saisonnier
Le chiffre d’affaires a atteint 5,57 M€ la première année et 5,58 M€ la seconde : une hausse de moins de 10 000 €, autrement dit une quasi-stabilité.
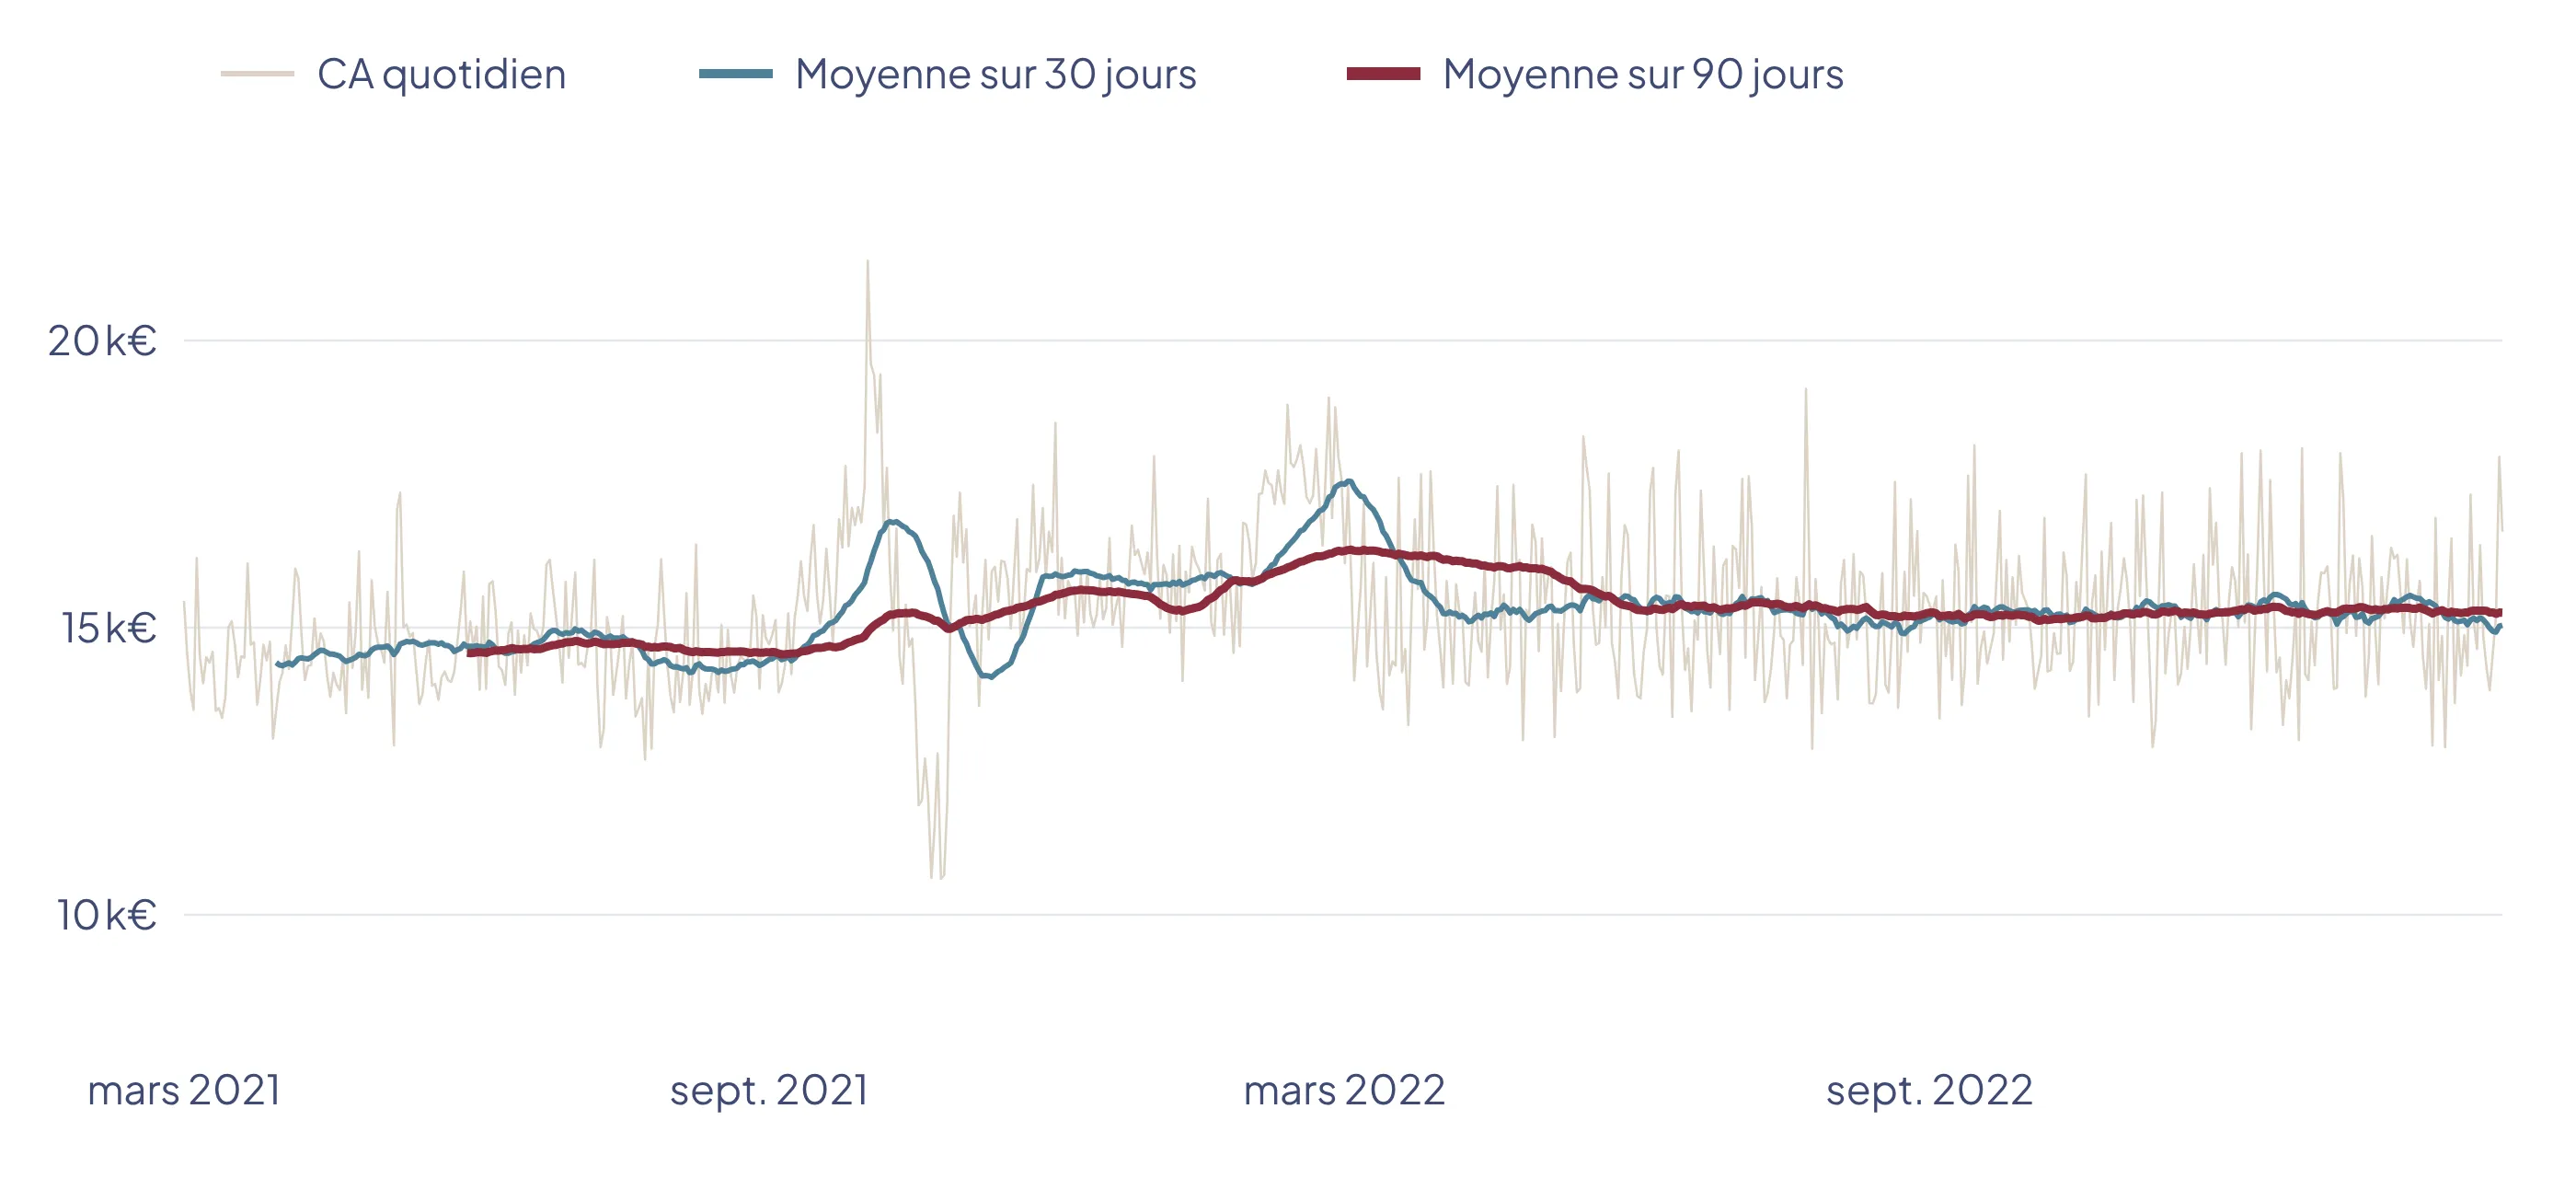
Le chiffre d’affaires quotidien oscille entre environ 12 000 € et 20 000 €. Les moyennes mobiles lissent le bruit pour faire ressortir la tendance.
Le chiffre quotidien est trop bruité pour être lu tel quel, j’ai donc superposé deux moyennes mobiles. La moyenne sur 30 jours révèle la saisonnalité : des creux en juillet et en novembre 2021, des pics en octobre 2021 et en février 2022. La moyenne sur 90 jours montre la tendance de fond : une hausse jusqu’en mars 2022, puis un plateau autour de 15 000 € par jour.
Tous les indicateurs d’activité racontent la même histoire, celle d’une entreprise arrivée à maturité :
| Moyenne mensuelle | Année 1 | Année 2 |
|---|---|---|
| Clients | 5 757 | 5 754 |
| Commandes | 13 422 | 13 454 |
| Commandes par client | 2,33 | 2,34 |
| Livres vendus | 26 855 | 26 540 |
| Panier moyen | 34,58 € | 34,54 € |
Cette stabilité est rassurante, avec une clientèle fidèle, mais c’est aussi un signal d’alerte : sans nouveaux leviers, le chiffre d’affaires va stagner.
Le catalogue : d’où vient le chiffre d’affaires
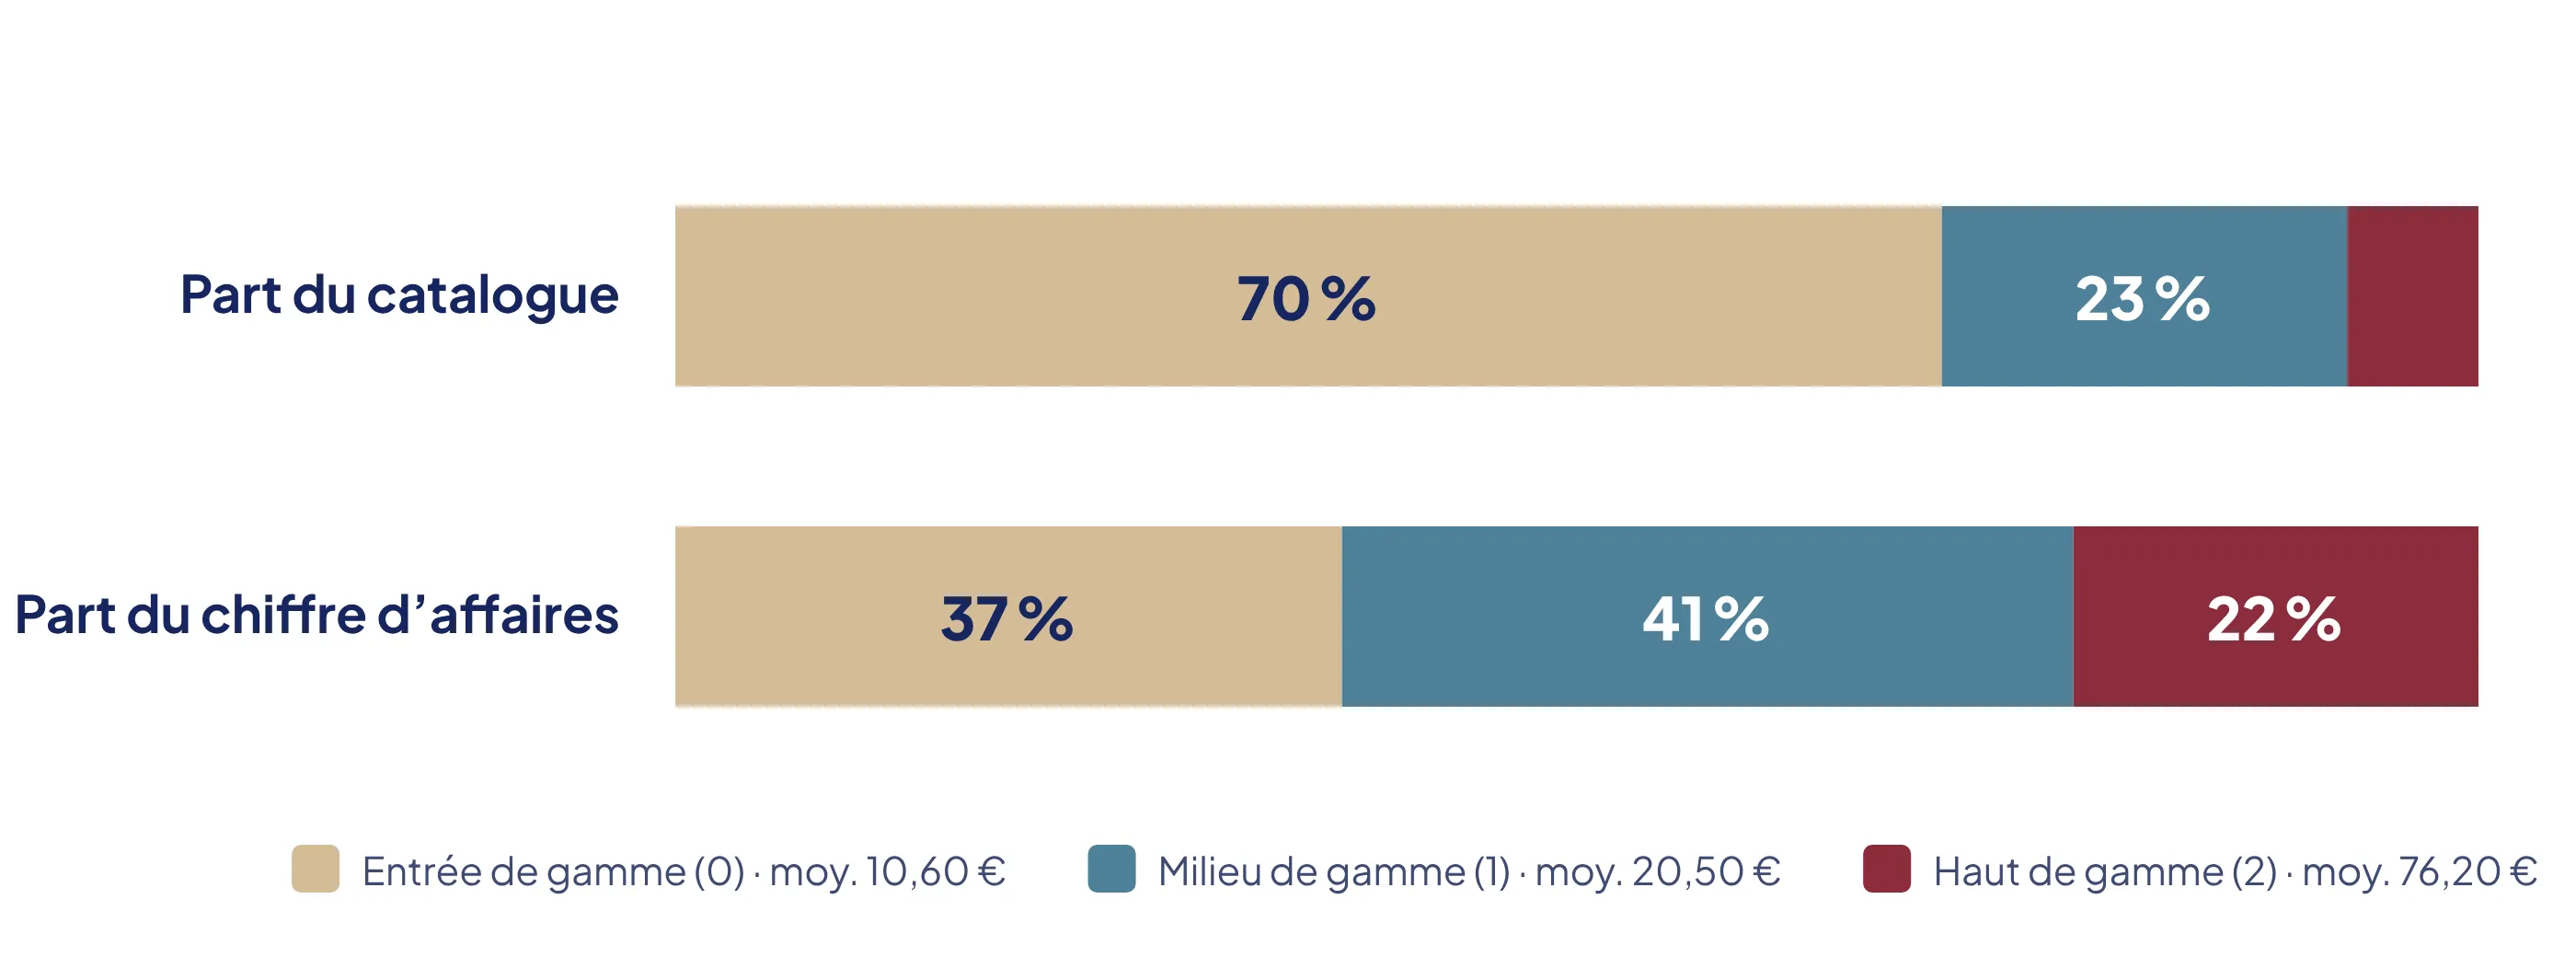
Les trois catégories se comportent très différemment. L’entrée de gamme (prix moyen 10,60 €) représente 70 % du catalogue mais n’apporte que 37 % du chiffre d’affaires. Le milieu de gamme (20,50 €) est celui qui rapporte le plus : 41 % du total pour 23 % des références. Le haut de gamme (76,20 €) ne pèse que 7 % du catalogue, mais ses prix, sept fois supérieurs à ceux de l’entrée de gamme, lui valent 22 % du chiffre d’affaires. Ces proportions restent les mêmes mois après mois : c’est une caractéristique structurelle du catalogue, pas un effet saisonnier.
La concentration suit presque exactement le principe de Pareto : 21,5 % des références génèrent 80 % du chiffre d’affaires, et 24,8 % génèrent 80 % des volumes. Le top 20 en chiffre d’affaires est composé de titres milieu et haut de gamme, emmené par la référence 2_159 avec 91 000 € ; le top 20 en volume est entièrement milieu de gamme. À l’autre extrémité, sur les 21 références jamais vendues, 16 relèvent de l’entrée de gamme, et cette catégorie n’apparaît dans aucun top. Elle mérite un audit.
Les clients : une base large et fidèle
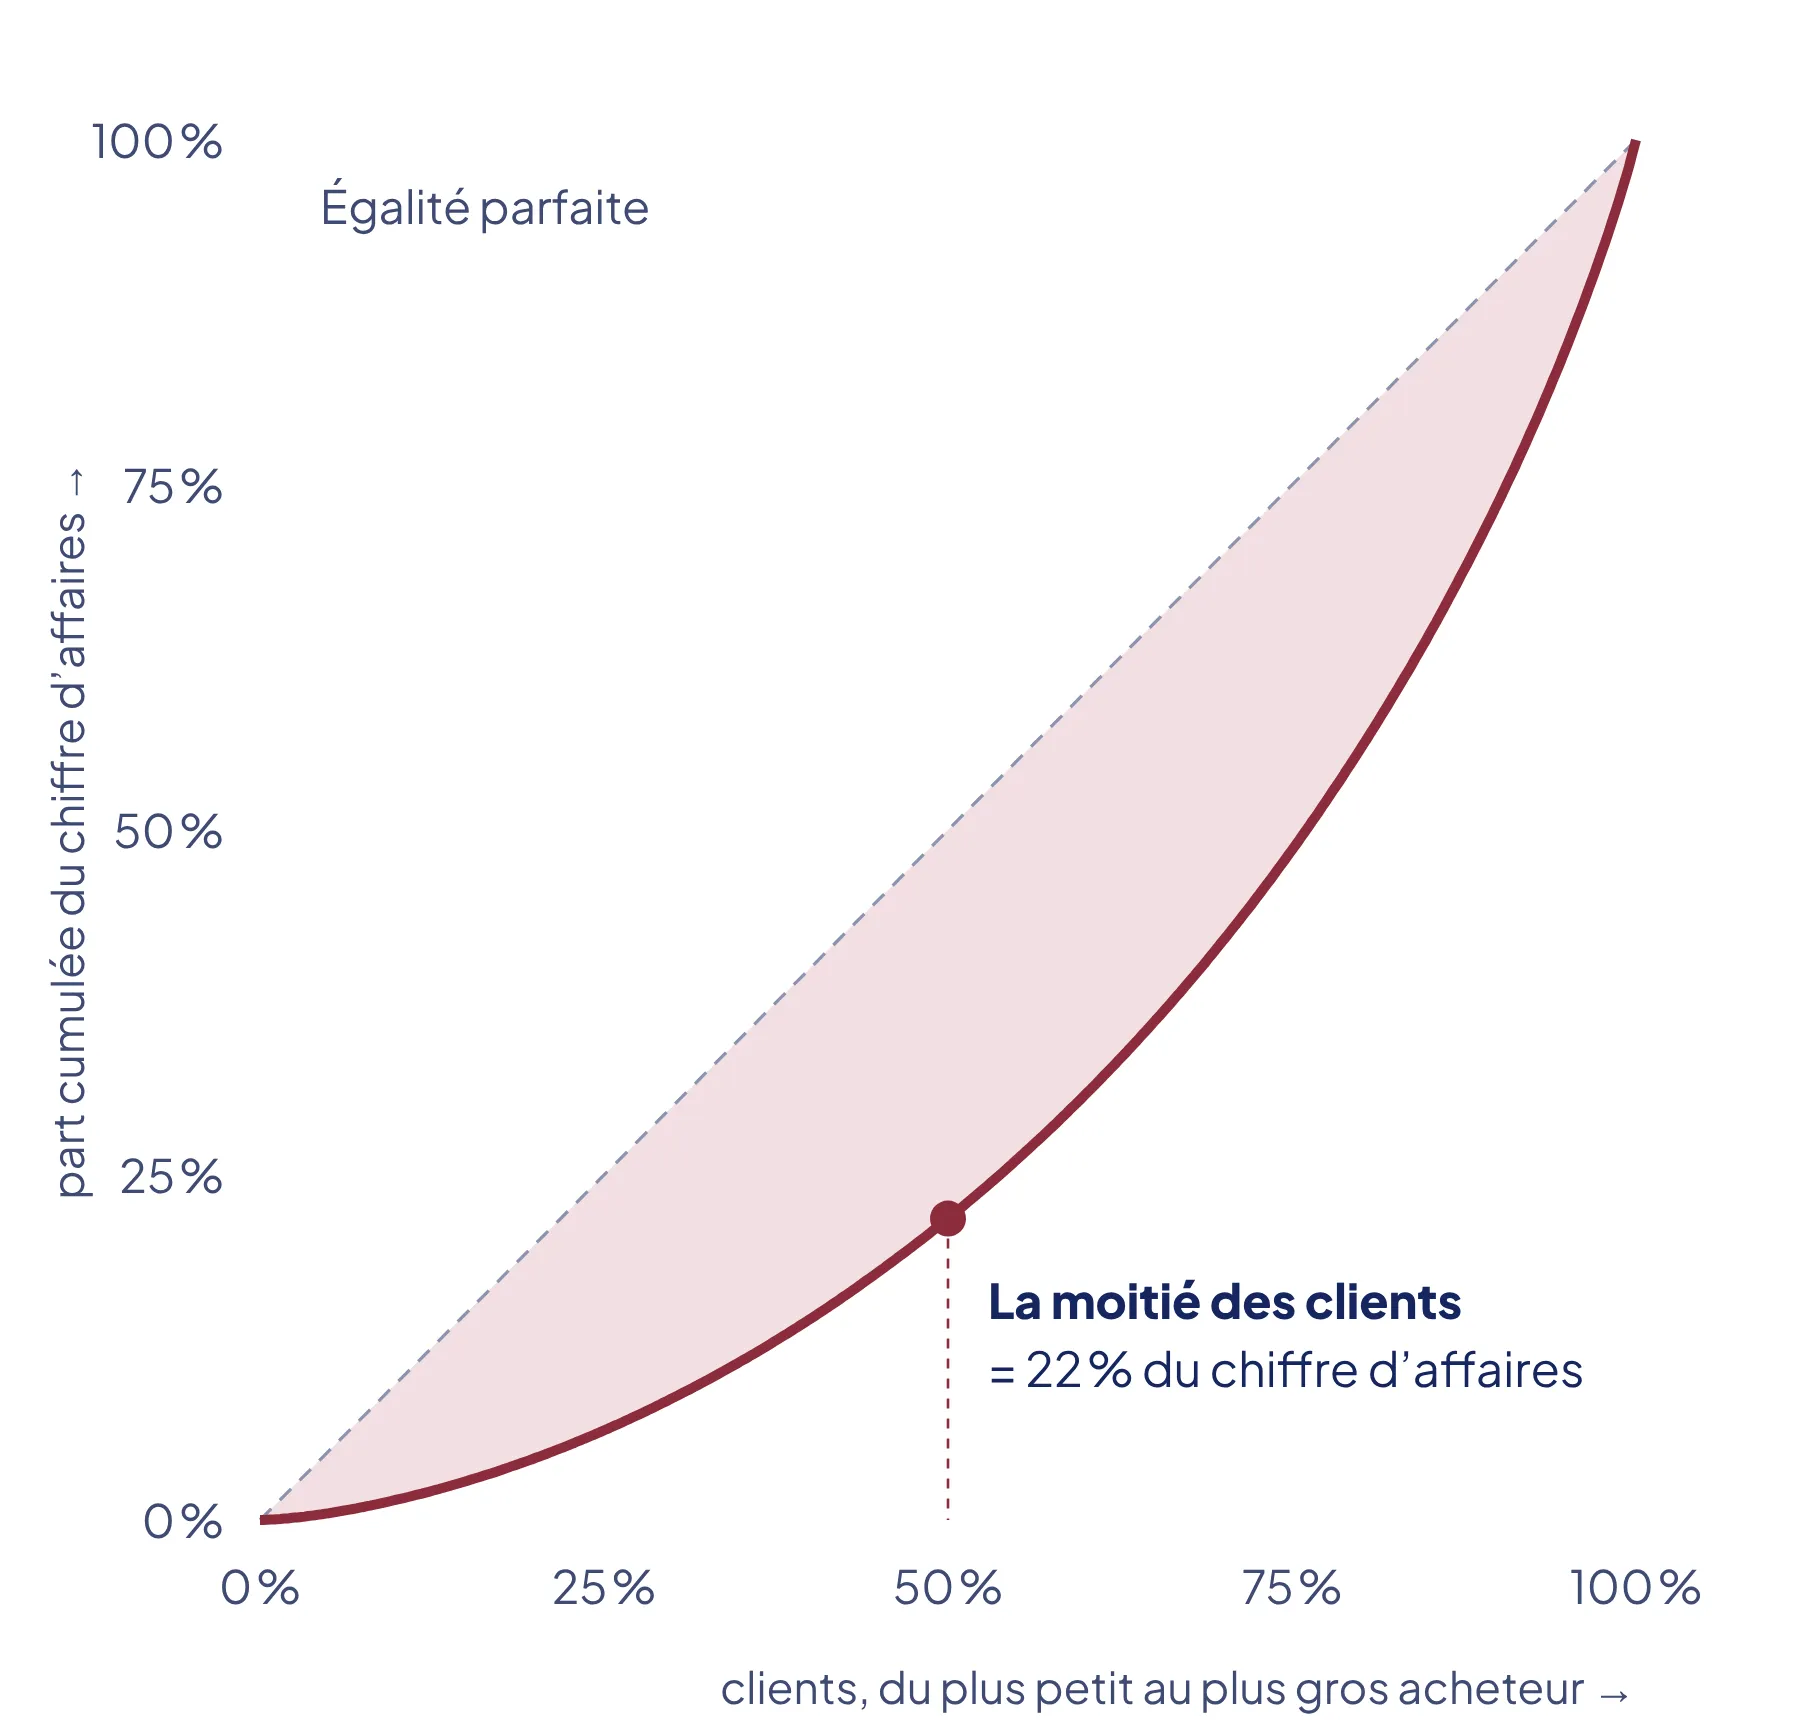
La courbe de Lorenz montre une concentration modérée (indice de Gini de 0,40) : la moitié des clients qui dépensent le moins génère tout de même 22 % du chiffre d’affaires, et il faut 52 % des clients pour en atteindre 80 %, loin du classique 20/80. Même les 20 meilleurs clients sont remarquablement proches les uns des autres, entre 4 800 € et 5 300 € chacun. La librairie ne dépend pas de quelques clients stars, mais d’une clientèle large, fidèle et régulière, ce qui la rend résiliente.
Les cinq questions de Julie
Pour les tests statistiques, une règle comptait avant tout : des observations indépendantes. Un client qui achète 150 livres ne doit pas compter 150 fois. Tous les tests sont donc menés au niveau client, une ligne par client, et pour les questions sur les catégories, chaque client se voit attribuer la catégorie qu’il achète le plus.
# Une ligne par client, avec la catégorie qu'il achète le plus
df_categorie_principale_client = (
    df_merge_transaction_products_customers.groupby(["client_id", "sex"])["categ"]
    .agg(lambda x: x.value_counts().index[0])
    .reset_index()
)
Avant de mesurer des corrélations entre variables numériques, j’ai vérifié si les données suivaient une loi normale, condition du test de Pearson. Ce n’est pas le cas : l’âge est réparti de façon presque uniforme, les dépenses sont très asymétriques, et le test de Shapiro-Wilk (sur un échantillon de 5 000, la limite de l’implémentation SciPy) rejette nettement la normalité. J’ai donc utilisé le test de Spearman, qui ne repose pas sur cette hypothèse.
| Question de Julie | Test | Pourquoi ce test | Résultat | Verdict |
|---|---|---|---|---|
| Genre × catégorie | Khi-deux | Deux variables qualitatives | χ² = 4,89 p = 0,086 | Pas de lien |
| Âge × montant total | Spearman | Deux variables quantitatives non normales | ρ = −0,18 p < 0,001 | Pas de corrélation notable |
| Âge × fréquence d’achat | Spearman | Deux variables quantitatives non normales | ρ = 0,21 p < 0,001 | Pas de corrélation notable |
| Âge × panier moyen | Spearman | Deux variables quantitatives non normales | ρ = −0,70 p < 0,001 | Corrélation négative nette |
| Âge × catégorie | Kruskal-Wallis et ANOVA | Une variable quantitative, une qualitative à trois groupes | H = 2 004 F = 1 202 p < 0,001 | Lien fort |
Deux résultats demandaient de la prudence. Pour l’âge croisé avec le montant total et la fréquence, les p-valeurs sont minuscules, donc les liens sont statistiquement réels, mais les coefficients restent compris entre −0,25 et +0,25 : par convention, une corrélation aussi faible est considérée comme négligeable. Significatif ne veut pas dire fort. Et pour le genre, une p-valeur de 0,086 est proche de 0,05, mais le seuil se fixe avant le test, il ne se déplace pas après avoir vu le résultat.
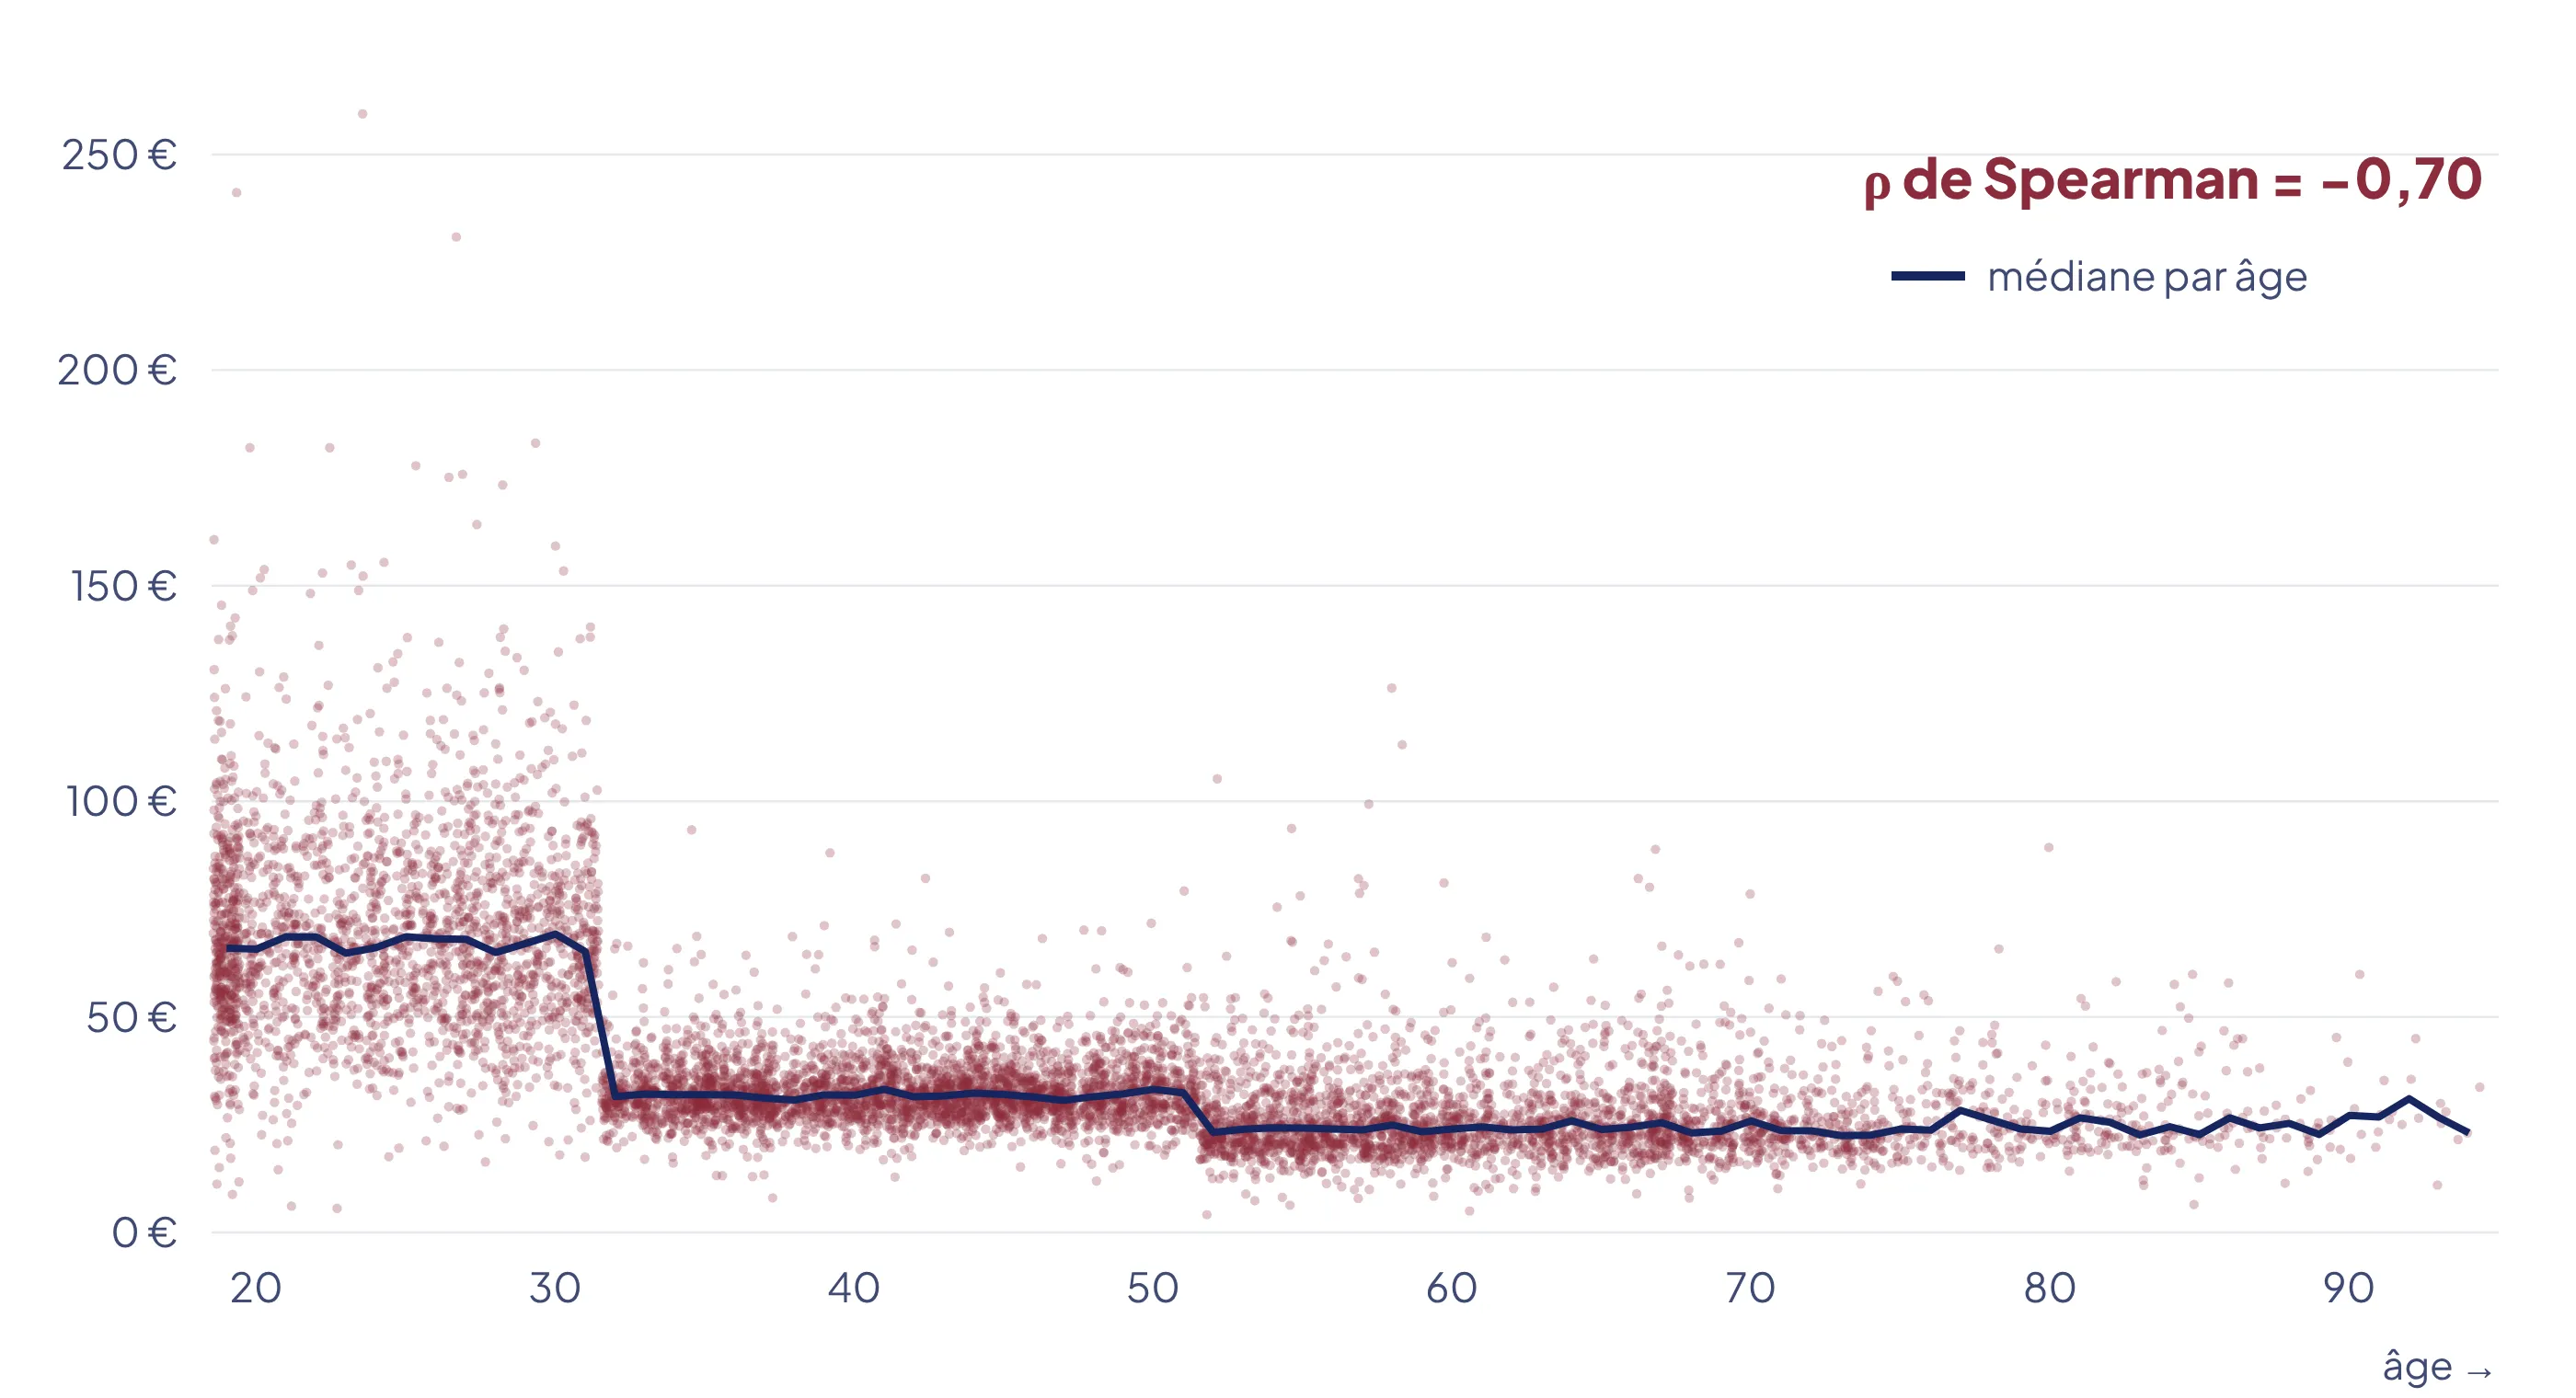
Chaque point est un client. Les clients de plus de 70 ans ne dépassent jamais 90 € par commande.
La seule corrélation forte relie l’âge au panier moyen. Les clients de moins de 30 ans dépensent beaucoup plus par commande, avec une médiane autour de 67 € et certains paniers au-delà de 150 €, et une rupture nette apparaît vers 30 ans, au-delà de laquelle la plupart des paniers retombent entre 20 et 40 €.
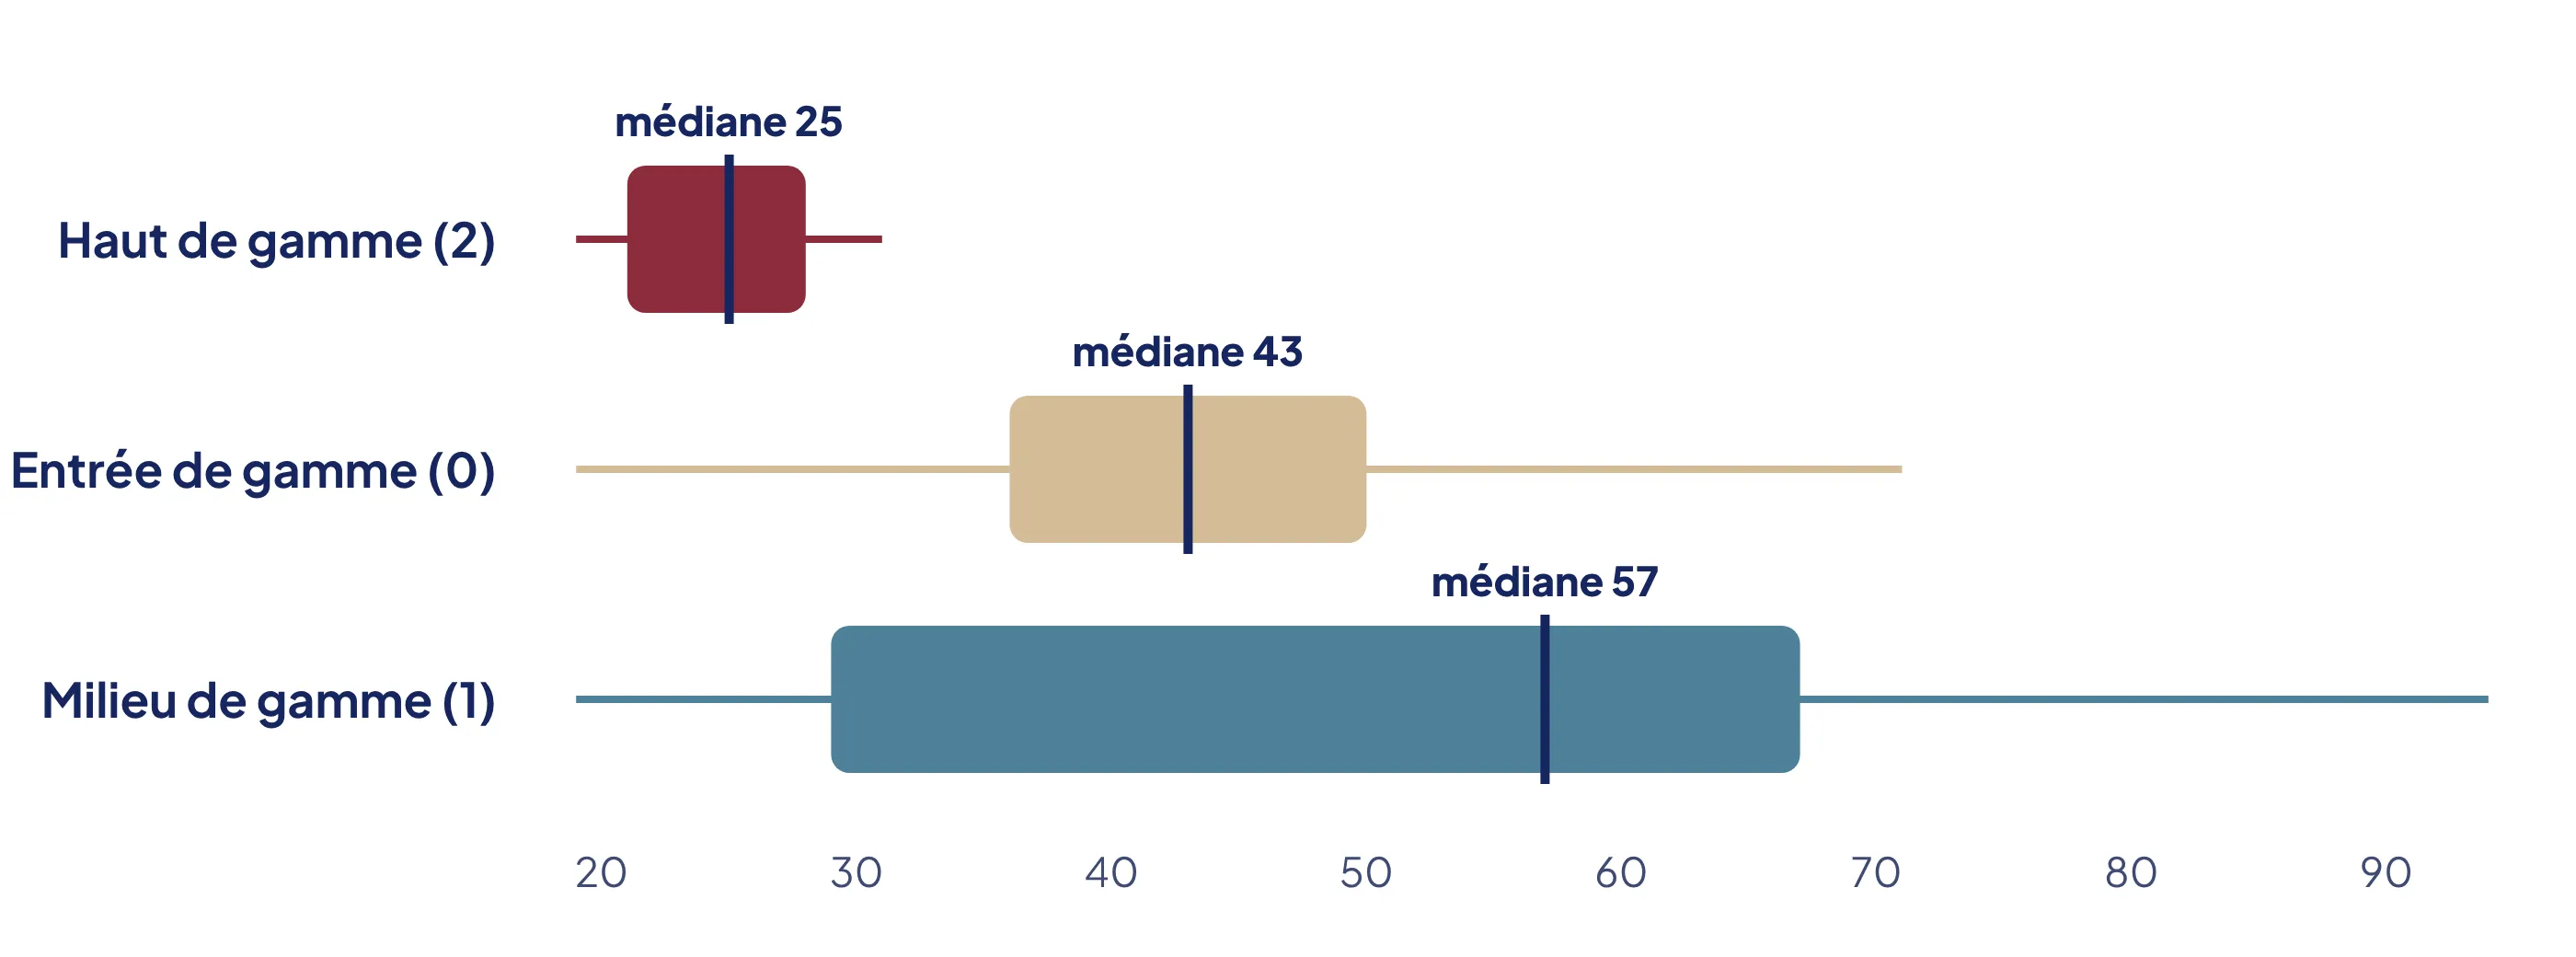
L’âge sépare aussi nettement les catégories : les acheteurs du haut de gamme ont un âge médian de 25 ans, ceux de l’entrée de gamme 43 ans, ceux du milieu de gamme 57 ans. J’ai réalisé un test de Kruskal-Wallis, le plus adapté puisque l’âge ne suit pas une loi normale, puis une ANOVA comme contrôle de robustesse. En principe, l’ANOVA suppose des données normales. Mais le théorème central limite montre qu’avec un échantillon assez grand (au-delà d’une trentaine d’observations), les moyennes que compare l’ANOVA suivent à peu près une loi normale, quelle que soit la forme des données. Avec 8 596 clients, l’ANOVA reste donc fiable malgré l’absence de normalité. Les deux tests rejettent l’hypothèse nulle avec des p-valeurs proches de zéro : l’âge diffère nettement d’une catégorie à l’autre.
Recommandations
- Arrêter de segmenter là où cela ne rapporte rien. Aucun lien significatif n’a été trouvé entre le genre et les catégories, et l’âge influe à peine sur le montant total ou la fréquence : des campagnes universelles sont aussi efficaces, et bien moins coûteuses à produire que des dizaines de campagnes segmentées.
- Cibler les moins de 30 ans pour le haut de gamme : ce sont les principaux acheteurs de cette catégorie, et ceux qui dépensent le plus par commande.
- Adapter le ton et le canal de communication à chaque catégorie, selon le profil de ses acheteurs : grand public pour l’entrée de gamme, seniors pour le milieu de gamme, jeunes adultes pour le haut de gamme.
- Augmenter le panier des plus de 30 ans avec de la vente additionnelle, des offres groupées ou des facilités de paiement.
- Auditer l’entrée de gamme : elle représente 70 % du catalogue, n’apparaît dans aucun top et regroupe 16 des 21 références jamais vendues. Revoir ces références permettrait de mettre davantage en avant les références phares.
- Développer le segment B2B, qui pèse déjà 7 % du chiffre d’affaires avec seulement quatre clients, en proposant des tarifs professionnels, à commencer par les trois références qu’ils sont seuls à acheter.
Limites
- Corrélation n’est pas causalité. L’âge est lié au montant du panier, mais les données ne disent pas pourquoi.
- Une seule catégorie par client. Pour les tests sur les catégories, chaque client est résumé par la catégorie qu’il achète le plus, ce qui masque les clients qui achètent dans plusieurs catégories.
- Le seuil de ±0,25 pour qualifier une corrélation de notable est une convention issue de ma formation ; d’autres références retiennent des seuils différents, ce qui ne changerait pas le seul résultat fort.
Ce que j’en retiens
Travailler au niveau client est ce qui a rendu les tests honnêtes : quelqu’un qui achète 150 livres doit compter une fois, pas 150 fois. L’autre leçon, c’est que significatif ne veut pas dire fort : une p-valeur minuscule m’indiquait qu’un lien existait, pas qu’il comptait pour le marketing. Enfin, un test qui ne trouve rien reste un résultat utile : montrer à Julie que le genre ne change rien aux catégories achetées, c’est lui éviter de produire des campagnes segmentées qui ne rapporteraient rien de plus.