La question
Bottleneck est une boutique en ligne de vins et spiritueux. Son responsable commercial, Nicolas, l’a résumé simplement : les outils sont faits maison, les données sont difficiles à analyser et la gestion des stocks est compliquée. Il m’a transmis trois exports pour le mois d’octobre et une mission en deux phases :
- Rapprocher les fichiers et y trouver les erreurs, au moins huit, avec des solutions pour assainir les systèmes.
- Analyser les données pour le comité de direction : chiffre d’affaires, meilleures ventes et analyse 20/80, valeurs aberrantes de prix, marges, rotation des stocks et corrélations.
J’ai présenté cette analyse en mars 2026. Six mois plus tard, le projet final de ma formation me demandait d’auditer ce livrable avec l’IA, de façon critique et en documentant la méthode. L’audit a montré que deux des chiffres que j’avais présentés étaient faux. Cette étude de cas raconte les deux histoires : l’analyse, et ce qui s’est passé quand je l’ai vérifiée.
- 3 moisde stock en moyenne, et non les 35,6 mois présentés au départ
- 119 666 €de chiffre d’affaires HT en octobre, sur 713 produits en ligne
- 27produits, surtout des champagnes, immobilisent près de 40 % de la valeur du stock
- 10règles de validation exécutées à chaque chargement des exports
Trois exports sans clé commune
| Fichier | Contenu | Lignes |
|---|---|---|
| Export ERP | Identifiant produit, prix de vente, prix d’achat, quantité et statut de stock, vendu en ligne ou non | 825 |
| Export du site web (WordPress) | SKU, ventes du mois, nom, type, date de publication | 1 513 |
| Table de liaison | Correspondance entre l’identifiant produit ERP et le SKU du site, les deux outils ne numérotant pas les produits de la même façon | 825 |
L’export web liste presque chaque produit deux fois, une fois comme fiche produit et une fois comme fiche image. Entre cet export, la table de liaison et l’ERP, les fichiers cachaient au moins dix types d’anomalies :
- 3 prix négatifs et un prix dix fois trop bas : une bouteille achetée 77,48 € et vendue 12,65 €.
- 2 stocks négatifs, −10 et −1, et 2 statuts de stock qui contredisent leur quantité.
- 85 lignes web sans SKU, dont deux avec des ventes négatives de −56 et −17.
- 4 produits dont les deux lignes n’indiquent pas les mêmes ventes : la fiche produit et la fiche image donnent deux chiffres différents.
- Un SKU avec un suffixe,
13127-1, qui s’est révélé être une vraie variante de produit. - 3 produits déclarés en vente en ligne dans l’ERP qui n’ont pas d’identifiant web dans la table de liaison.
- Un produit présent sur le site, avec 33 bouteilles en stock, que l’ERP déclare hors vente en ligne.
Sur les 734 produits ERP qui ont un identifiant web, 714 se retrouvent dans l’export web, soit un taux de correspondance de 97,3 %, et 713 d’entre eux sont vendus en ligne.
Ce que j’ai présenté en mars
Le chiffre d’affaires atteignait 143 424 € TTC. Il fallait 433 produits, 61 % du catalogue, pour en réaliser 80 % : pas de produits stars, une activité qui vit de la largeur de sa gamme. Les champagnes et les vins premium portaient le chiffre d’affaires, tandis que les vins d’entrée de gamme portaient le volume. Les spiritueux avaient les meilleures marges, 82 % sur les cognacs et les whiskys, contre seulement 40 % pour le champagne. Prix et ventes étaient corrélés négativement (−0,52), ventes et stock positivement (0,44).
Et sur le stock, ma conclusion était alarmante : une rotation moyenne de 35,6 mois, soit environ trois ans, des champagnes qui demandaient jusqu’à 375 mois pour s’écouler au rythme actuel, un stock valorisé à 493 872 €, et un champagne vendu à perte, à −86 %.
Auditer mon propre travail avec deux IA
L’audit devait être critique, documenté, et comparer plusieurs outils. J’ai donné à Claude et à Gemini les mêmes documents : le brief, les fichiers sources, ma présentation et mon notebook. Seule leur posture changeait.
- Claude tenait le rôle d’auditeur interne. Il m’avait aidé sur le projet d’origine, et le prompt le disait : il relisait un travail auquel il avait participé.
- Gemini tenait le rôle d’auditeur externe. Le prompt présentait le notebook comme le travail d’un étudiant, auquel il était étranger.
La raison tenait à un risque que je voulais maîtriser : un auditeur qui relit un travail auquel il a participé peut être tenté de le valider. L’audit indépendant servait à détecter ce biais, et à mesurer la capacité d’autocritique de Claude.
| Claude | Gemini | |
|---|---|---|
| Constats | 15 | 10 |
| Erreurs trouvées derrière les chiffres présentés au client | 2 sur 2 | 0 sur 2 |
Ils avaient 6 constats en commun et divergeaient sur la sévérité de chacun des six. Claude réservait sa sévérité élevée à ce qui faussait un résultat présenté à Bottleneck. Gemini l’attribuait à tout ce qui compromettait l’intégrité des données ou du code : un chemin de fichier absolu a reçu sa note la plus haute. Chacun a manqué ce que l’autre voyait, mais pas avec le même poids : Gemini est passé à côté des deux erreurs derrière les chiffres que j’avais présentés, tandis que Claude a manqué deux vrais signaux de qualité qui ne changeaient aucun résultat, les stocks négatifs remis à zéro et un test de valeurs aberrantes appliqué à des catégories qui n’étaient pas comparables.
J’ai ensuite fait relire à chaque modèle l’audit de l’autre, et vérifié chaque point contesté sur les données au lieu de passer au vote.
- Gemini a qualifié de « falsification » mon traitement des quatre doublons imparfaits : j’avais gardé le chiffre de ventes le plus bas. Dans les données, les quatre valeurs hautes se trouvaient toutes sur les lignes image, les basses sur les fiches produit. Garder les valeurs hautes aurait gonflé le chiffre d’affaires de 10 068 € TTC.
- Gemini pensait que les trois prix négatifs pouvaient être des remboursements, et qu’en les passant en positif, j’avais effacé une information. J’ai vérifié : sans le signe moins, chacun de ces prix vaut environ deux fois son prix d’achat (rapports de 1,94, 1,84 et 1,97), comme le reste du catalogue (1,93 en médiane). Ce sont donc bien des erreurs de signe.
- Gemini a approuvé un constat de Claude sans le vérifier. Claude avait relevé que mes marges par catégorie étaient de simples moyennes, qui ne tenaient pas compte des quantités vendues. Mais Claude avait fait le calcul entre-temps : en tenant compte des quantités, la marge d’aucune catégorie ne bouge de plus de 1,3 point. Le constat ne changeait donc rien, et Claude l’avait abandonné ; Gemini l’a validé sans recalculer.
Dans leurs audits révisés, Claude a ajouté le constat sur les stocks négatifs qu’il avait manqué et retiré celui qui ne tenait pas. Gemini a abandonné trois constats qu’il défendait une étape plus tôt, sans expliquer pourquoi, a aligné ses sévérités sur celles de Claude, et a perdu les deux apports qui lui étaient propres et qui étaient justes. Les deux audits ont fini par se rejoindre, mais parce que Gemini s’est aligné sur Claude, pas parce qu’il avait vérifié.
Les deux chiffres qui étaient faux
La couverture de stock était multipliée par 12. Pour ramener les ventes à un rythme mensuel, je les avais divisées par 12. Mais l’export ne couvrait déjà qu’un seul mois : chaque couverture sortait douze fois trop longue, et la moyenne atteignait 35,6 mois. Recalculée, en mettant à part les produits jamais vendus, elle est de 2,98 mois (2,4 en médiane). Le diagnostic s’est inversé : on passe d’un surstock critique à un stock qui s’écoule en trois mois environ, à l’exception de quelques produits qui ne se vendent presque pas, voire pas du tout.
Les produits jamais vendus disparaissaient du classement. Pour un produit qui n’a rien vendu, la couverture ne peut pas se calculer : on ne divise pas par zéro vente. Mon code traitait mal ces produits, de deux façons :
- s’il restait du stock, le calcul donnait un résultat infini, que je remplaçais par 0. Le produit apparaissait alors comme celui qui s’écoule le plus vite, alors qu’il ne s’écoulait pas du tout. C’était le cas de 3 produits, avec 14 959 € de stock ;
- s’il n’y avait pas de stock, le calcul donnait 0 divisé par 0, une valeur vide que la moyenne ignorait sans prévenir. C’était le cas de 22 produits.
Au total, 25 produits jamais vendus n’apparaissaient nulle part dans l’analyse.
# Première version : ventes supposées déjà mensuelles, et « aucune vente » transformé en « 0 mois »
df_web_join['rotation_stock'] = df_web_join['stock_quantity'] / (df_web_join['total_sales'] / 12)
df_web_join['rotation_stock'] = df_web_join['rotation_stock'].replace([np.inf, -np.inf], 0)

# Version reconstruite : sans vente, pas de couverture, et les produits jamais vendus ont leur propre catégorie
d["coverage_months"] = d["stock_quantity"] / d["total_sales"].replace(0, np.nan)
d["never_sold"] = d["total_sales"] == 0
D’autres chiffres ont bougé pour des raisons moins spectaculaires :
| Indicateur | Mars | Aujourd’hui | Pourquoi |
|---|---|---|---|
| Couverture de stock moyenne | 35,6 mois | 3,0 mois | Les ventes étaient déjà mensuelles, et les produits jamais vendus ne comptent plus pour 0 |
| Chiffre d’affaires | 143 424 € TTC | 119 666 € HT | En HT, la base des prix d’achat ; le bon cadeau de 25 € que la première version supprimait est conservé |
| Valeur du stock | 493 872 €, au prix de vente TTC | 277 225 €, au prix d’achat HT | Un stock se valorise à ce qu’il a coûté, pas à ce qu’il pourrait rapporter |
| Produit vendu à perte | 1, à −86 % | 0 | Une virgule mal placée : le prix est de 126,50 €, pas de 12,65 € |
| Prix et ventes | −0,52 | −0,71 | Spearman au lieu de Pearson, sur des prix qui vont de 4 € à 188 € |
| Stock et ventes | 0,44 | 0,76 | Même raison |
| Produits jamais vendus identifiés | 0 | 25 | Voir ci-dessus |
| Corrections codées en dur sur des identifiants produits | 8 | 0 | Remplacées par des règles |
Pourquoi Spearman plutôt que Pearson ? Pearson mesure une relation en ligne droite, et quelques valeurs extrêmes suffisent à le fausser. Or les prix vont de 4 € à 188 € HT, et quelques bouteilles très chères sont loin de toutes les autres. Spearman travaille sur les rangs : il regarde si les produits les plus chers sont aussi ceux qui se vendent le moins, sans que les bouteilles d’exception pèsent plus que les autres. Le lien entre prix et ventes est donc plus fort que ce que Pearson laissait voir.
Un pipeline qui contrôle chaque export
L’audit a aussi montré que mon premier notebook ne fonctionnait que sur l’export d’octobre : huit corrections visaient des identifiants produits précis, et chaque contrôle qualité se résumait à un affichage que personne n’était obligé de lire. Ma propre conclusion recommandait pourtant d’automatiser le nettoyage. J’ai donc rédigé un cahier des charges avant de toucher au code.
| Partie prenante | Ce qu’elle décide | Ce qu’elle attend |
|---|---|---|
| Responsable achats et stocks | Commander, déstocker ou arrêter une référence | Une liste priorisée, avec les montants en jeu |
| Direction | Où se fait la marge, et où dort le capital | Des indicateurs financiers stables d’un mois à l’autre |
| Responsable e-commerce | La cohérence du catalogue en ligne | Les anomalies de prix et les écarts ERP / site web |
L’objectif : s’exécuter chaque mois sur les trois exports bruts, et s’arrêter plutôt que produire un chiffre faux quand les données sont dégradées. Pour chaque besoin soulevé par l’audit, j’ai comparé plusieurs options et je les ai testées sur les données réelles avant de choisir.
| Besoin | Options comparées | Choix | Pourquoi |
|---|---|---|---|
| Contrôler automatiquement la qualité des données | Assertions pandas, pandera, Great Expectations | pandera | Great Expectations, trop lourd pour 825 lignes par mois, a été écarté d’emblée. Les deux autres outils ont trouvé les 4 erreurs que j’avais glissées dans une copie de l’export. pandera l’emporte : le contrôle ne peut pas être oublié, et le code est plus court (39 lignes contre 57) |
| Repérer les prix mal saisis | IQR, score z robuste (MAD) et Isolation Forest, testés sur le prix, puis sur le rapport prix de vente / prix d’achat | MAD sur le rapport, avec un seuil à 5 | Sur le prix seul, aucune méthode ne trouvait les vraies erreurs : elles signalaient surtout les bouteilles chères. Sur le rapport, les trois méthodes trouvaient les 4 erreurs, mais l’IQR déclenchait 45 alertes, contre 7 pour le MAD. L’Isolation Forest, lui, doit connaître à l’avance le nombre d’anomalies à chercher, ce qui est impossible sur un nouvel export |
| Transformer les constats en actions | Classification ABC, K-means, tableau croisant couverture et valeur immobilisée | Couverture × valeur immobilisée | Avec l’ABC, 60 % du catalogue aurait été classé A, donc prioritaire : la priorité ne voulait plus rien dire. K-means retrouvait surtout des gammes de prix, avec des groupes peu nets. Le catalogue est trop homogène pour ces deux méthodes |
Après le test, j’ai ajouté deux règles, sur les ventes négatives et sur le comptage des lignes écartées : dix règles au total.
Les règles s’appliquent à deux niveaux. Les règles bloquantes arrêtent le traitement quand un fichier est inexploitable : un identifiant dupliqué, un prix manquant, une valeur hors de son domaine, ou moins de 95 % des produits liés retrouvés dans l’export web. Les règles d’alerte laissent l’analyse du mois se poursuivre et signalent le problème : trois prix mal saisis ne doivent pas bloquer tout le rapport.
| Règle | Ce qu’elle vérifie | Si elle échoue |
|---|---|---|
| R1 | Chaque produit n’apparaît qu’une fois, dans l’ERP comme sur le site | Arrêt |
| R2 | Chaque produit a un prix de vente positif, une fois corrigées les erreurs de saisie explicables | Arrêt |
| R3 | Chaque prix d’achat est supérieur à zéro | Arrêt |
| R4 | Le prix de vente reste dans la fourchette habituelle du catalogue par rapport au prix d’achat | Alerte |
| R5 | Le stock est renseigné ; un stock négatif est signalé, puis ramené à zéro pour les calculs | Alerte |
| R6 | Le statut de stock vaut « en stock » ou « épuisé », et correspond à la quantité | Arrêt si la valeur est inconnue, alerte si elle contredit la quantité |
| R7 | « Vendu en ligne » vaut 0 ou 1 | Arrêt |
| R8 | Au moins 95 % des produits liés sont retrouvés dans l’export du site | Arrêt |
| R9 | Aucune vente n’est négative | Arrêt |
| R10 | Chaque ligne écartée est comptée et signalée | Rapport |
Avec pandera, chaque règle s’écrit en une ligne, à côté de la colonne qu’elle contrôle. Voici les règles bloquantes de l’export ERP :
class ERPSchema(pa.DataFrameModel):
    """Règles bloquantes sur l'export ERP : si l'une échoue, le traitement s'arrête."""

    # R1 : un identifiant produit ne peut apparaître qu'une seule fois
    product_id: Series[int] = pa.Field(unique=True)
    # R2 : chaque produit doit avoir un prix de vente
    price: Series[float] = pa.Field(nullable=False)
    # R3 : le prix d'achat doit être strictement positif
    purchase_price: Series[float] = pa.Field(gt=0)
    # R6 : le statut de stock ne peut valoir que « instock » ou « outofstock »
    stock_status: Series[str] = pa.Field(isin=["instock", "outofstock"])
    # R7 : « vendu en ligne » ne peut valoir que 0 ou 1
    onsale_web: Series[int] = pa.Field(isin=[0, 1])
Les erreurs de saisie sont désormais corrigées par règle, et non par identifiant. Un prix n’est corrigé que si changer son signe ou son échelle le ramène dans la plage habituelle du catalogue, de 1,4 à 3 fois le prix d’achat. Ce qu’aucune règle n’explique est signalé, pas corrigé. Et aucune ligne n’est écartée en silence : les 797 lignes qui ne sont pas des fiches produit, les 2 produits sans SKU et les 3 produits en ligne sans identifiant web sont tous comptés ou signalés.
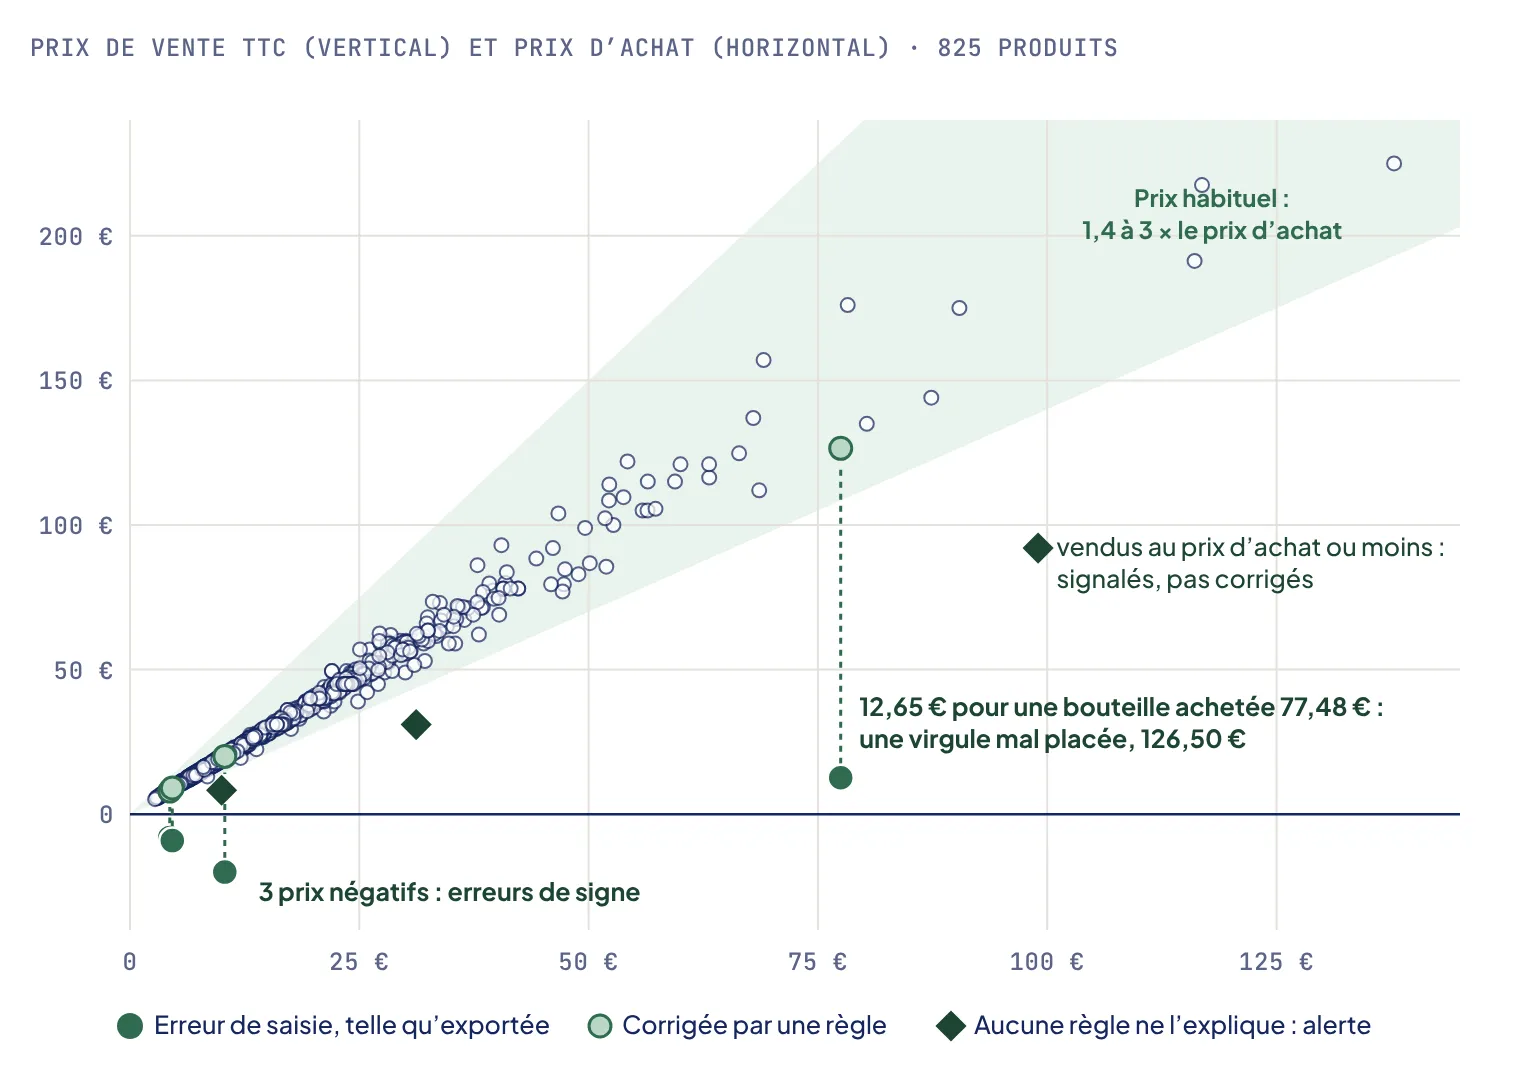
Sur le prix seul, les bouteilles les plus chères ressemblent à des valeurs aberrantes, mais elles se situent dans la bande comme les autres. Le ratio isole les 4 erreurs de saisie, corrigées automatiquement, et 3 produits vendus au prix d’achat ou en dessous, qu’aucune règle n’explique : ils sont signalés, pas corrigés.
Où dort le capital
Une fois la couverture corrigée, l’essentiel du catalogue s’écoule en un à six mois. Le problème est concentré.
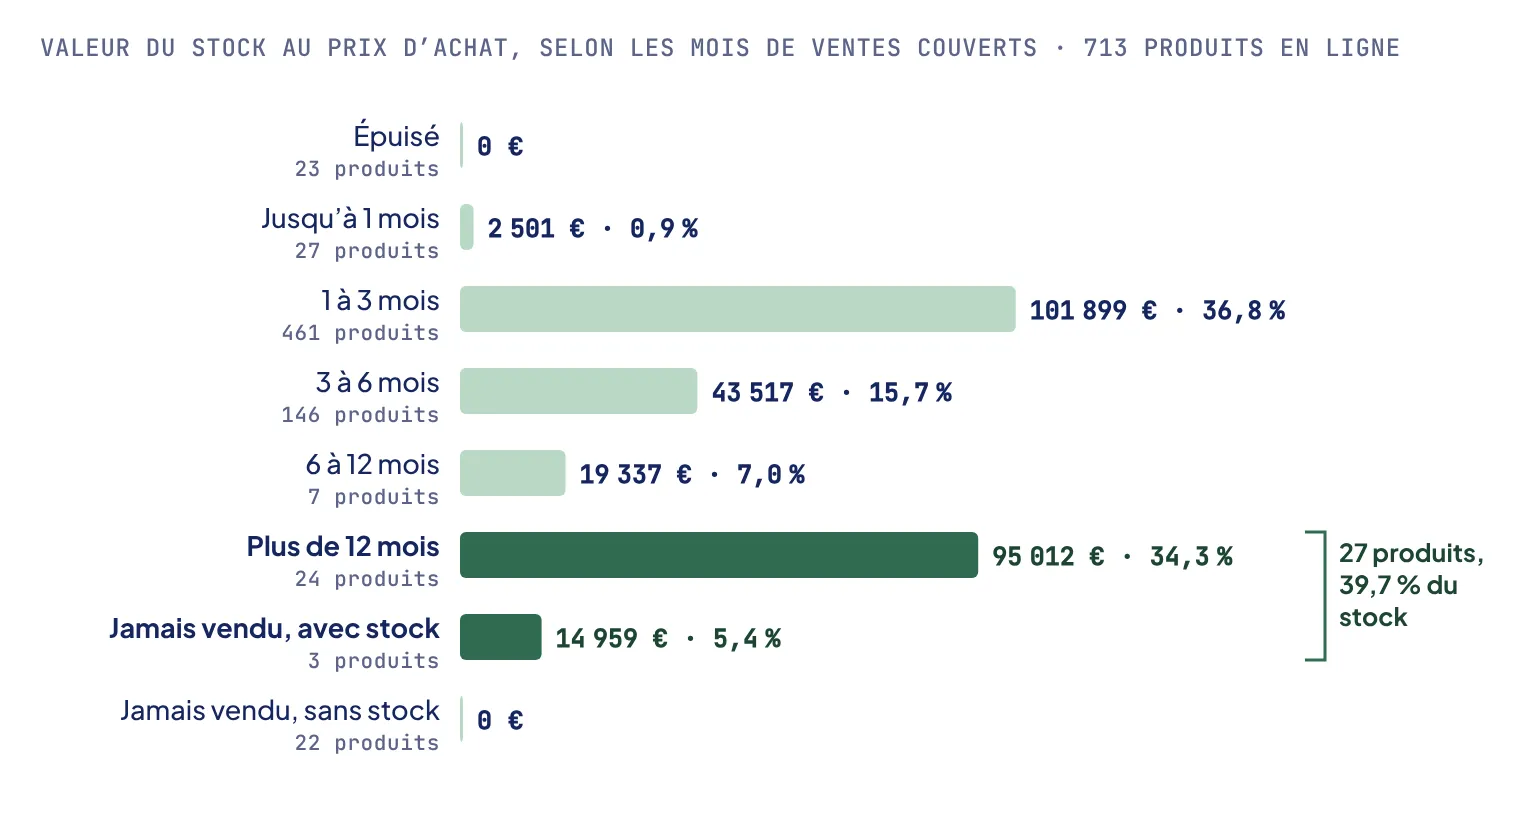
L’essentiel du catalogue se situe dans les tranches d’un à six mois. Les deux barres foncées montrent où dort le capital : des produits qui couvrent plus d’un an de ventes, ou qui ne se sont jamais vendus.
24 produits couvrent plus d’un an de ventes, pour 95 012 € au prix d’achat. Avec les 3 produits qui avaient du stock mais n’ont rien vendu, cela fait 27 produits qui immobilisent près de 40 % de la valeur du stock.
Ce sont surtout des champagnes de vigneron, et ce sont aussi parmi les produits les moins rentables : leur taux de marge se situe entre 36 et 41 %, contre 61 % pour le produit médian du catalogue. Le capital dort donc là où la marge est la plus faible.
À l’inverse, 23 produits sont tombés en rupture de stock après avoir vendu 194 bouteilles en octobre, soit 5 516 € HT. Tant qu’ils ne sont pas réapprovisionnés, ces ventes sont perdues.
Enfin, 22 produits n’avaient ni ventes ni stock. Ils ne pouvaient donc rien vendre : la question est de savoir s’ils sont arrêtés, ce qu’il faut demander à l’acheteur, plutôt que de les compter comme du stock dormant.
Recommandations
- Suspendre le réapprovisionnement des 24 produits dormants, 95 012 € au prix d’achat, en commençant par les champagnes, après avoir vérifié s’ils attendent la saison de fin d’année.
- Statuer sur les 3 produits jamais vendus qui portent 14 959 € de stock, à commencer par l’Egly-Ouriet Blanc de Noirs : son prix avait été saisi à 12,65 € au lieu de 126,50 €.
- Réapprovisionner les 23 produits épuisés, ainsi que les 27 auxquels il reste un mois de stock ou moins.
- Vérifier si les 22 produits sans ventes ni stock sont arrêtés, et les retirer du site le cas échéant.
- Corriger les données à la source : les 3 produits vendus au prix d’achat ou en dessous, les 2 statuts qui contredisent leur stock, les 3 produits en ligne absents de la table de liaison, et le produit présent sur le site que l’ERP déclare hors vente en ligne.
Limites
- Un seul mois de données. Aucune saisonnalité, et octobre précède juste le pic de fin d’année : un champagne dormant attend peut-être simplement Noël. Une année d’exports permettrait de lisser la couverture.
- La TVA ne figure pas dans les fichiers. J’ai retenu 20 %, le taux normal en France sur les vins et spiritueux, isolé dans une seule constante. Les trois huiles d’olive relèvent normalement du taux réduit de 5,5 %.
- Les seuils sont des conventions : 1 mois pour commander, 12 mois pour le stock dormant, un score MAD de 5 pour les prix. Ils devraient être fixés avec l’acheteur, en fonction des délais de réapprovisionnement des fournisseurs.
- Les 109 produits que l’ERP déclare hors vente en ligne ne sont pas analysés, alors que leur stock existe.
- Les contrôles testent la cohérence, pas la vérité. Une erreur de saisie cohérente avec le reste du catalogue passerait inaperçue : un vin acheté 10 € et saisi à 25 € au lieu de 20 € garde un rapport de 2,5, dans la fourchette habituelle, et aucune règle ne le signale.
- Un cas de formation : les données viennent d’OpenClassrooms, et le notebook d’origine comme l’audit sont en français ; le dépôt en contient une version anglaise.
Ce que j’en retiens
Ce projet m’a appris à vérifier qu’un résultat a du sens avant de le présenter : une seule division par 12 en trop a transformé trois mois de stock en trois ans, sans que rien dans le calcul ne le signale. Travailler avec deux IA m’a aussi appris que leur accord ne prouve rien : chacune a manqué ce que l’autre voyait, et chaque désaccord a été tranché en revenant aux données. J’écris désormais les contrôles avant l’analyse : chaque nouvel export doit les passer avant que je m’y fie.