La question
OpenClassrooms souhaitait comprendre comment le profil des étudiants inscrits à son parcours Data Analyst avait évolué sur quatre ans, pour nourrir sa réflexion sur l’accessibilité et l’égalité des chances. Les données internes avaient été collectées, mais elles nécessitaient une transformation fiable, documentée et reproductible, dans le strict respect du RGPD, et un enrichissement avec des données publiques de l’INSEE pour comparer les étudiants à la population française.
L’équipe travaillait déjà avec Snowflake et dbt : le livrable attendu était donc un pipeline dbt, un jeu de données final et une présentation destinée à un public non technique.
- 4 647inscriptions, de 2022 à 2025
- −44 %d’inscriptions entre 2022 et 2025
- 30 %de femmes, sans progression en quatre ans
- ×2,5surreprésentation de l’Île-de-France
Le pipeline
Plutôt qu’une grosse requête unique, j’ai découpé la transformation en couches successives, chacune avec un rôle précis. La couche staging nettoie et standardise chaque source brute, un modèle par source. La couche intermédiaire applique la logique métier, comme le passage d’une ligne par inscription à une ligne par étudiant. La couche marts produit les tables finales, prêtes pour l’analyse. Si un chiffre est faux, je sais exactement quelle couche examiner.
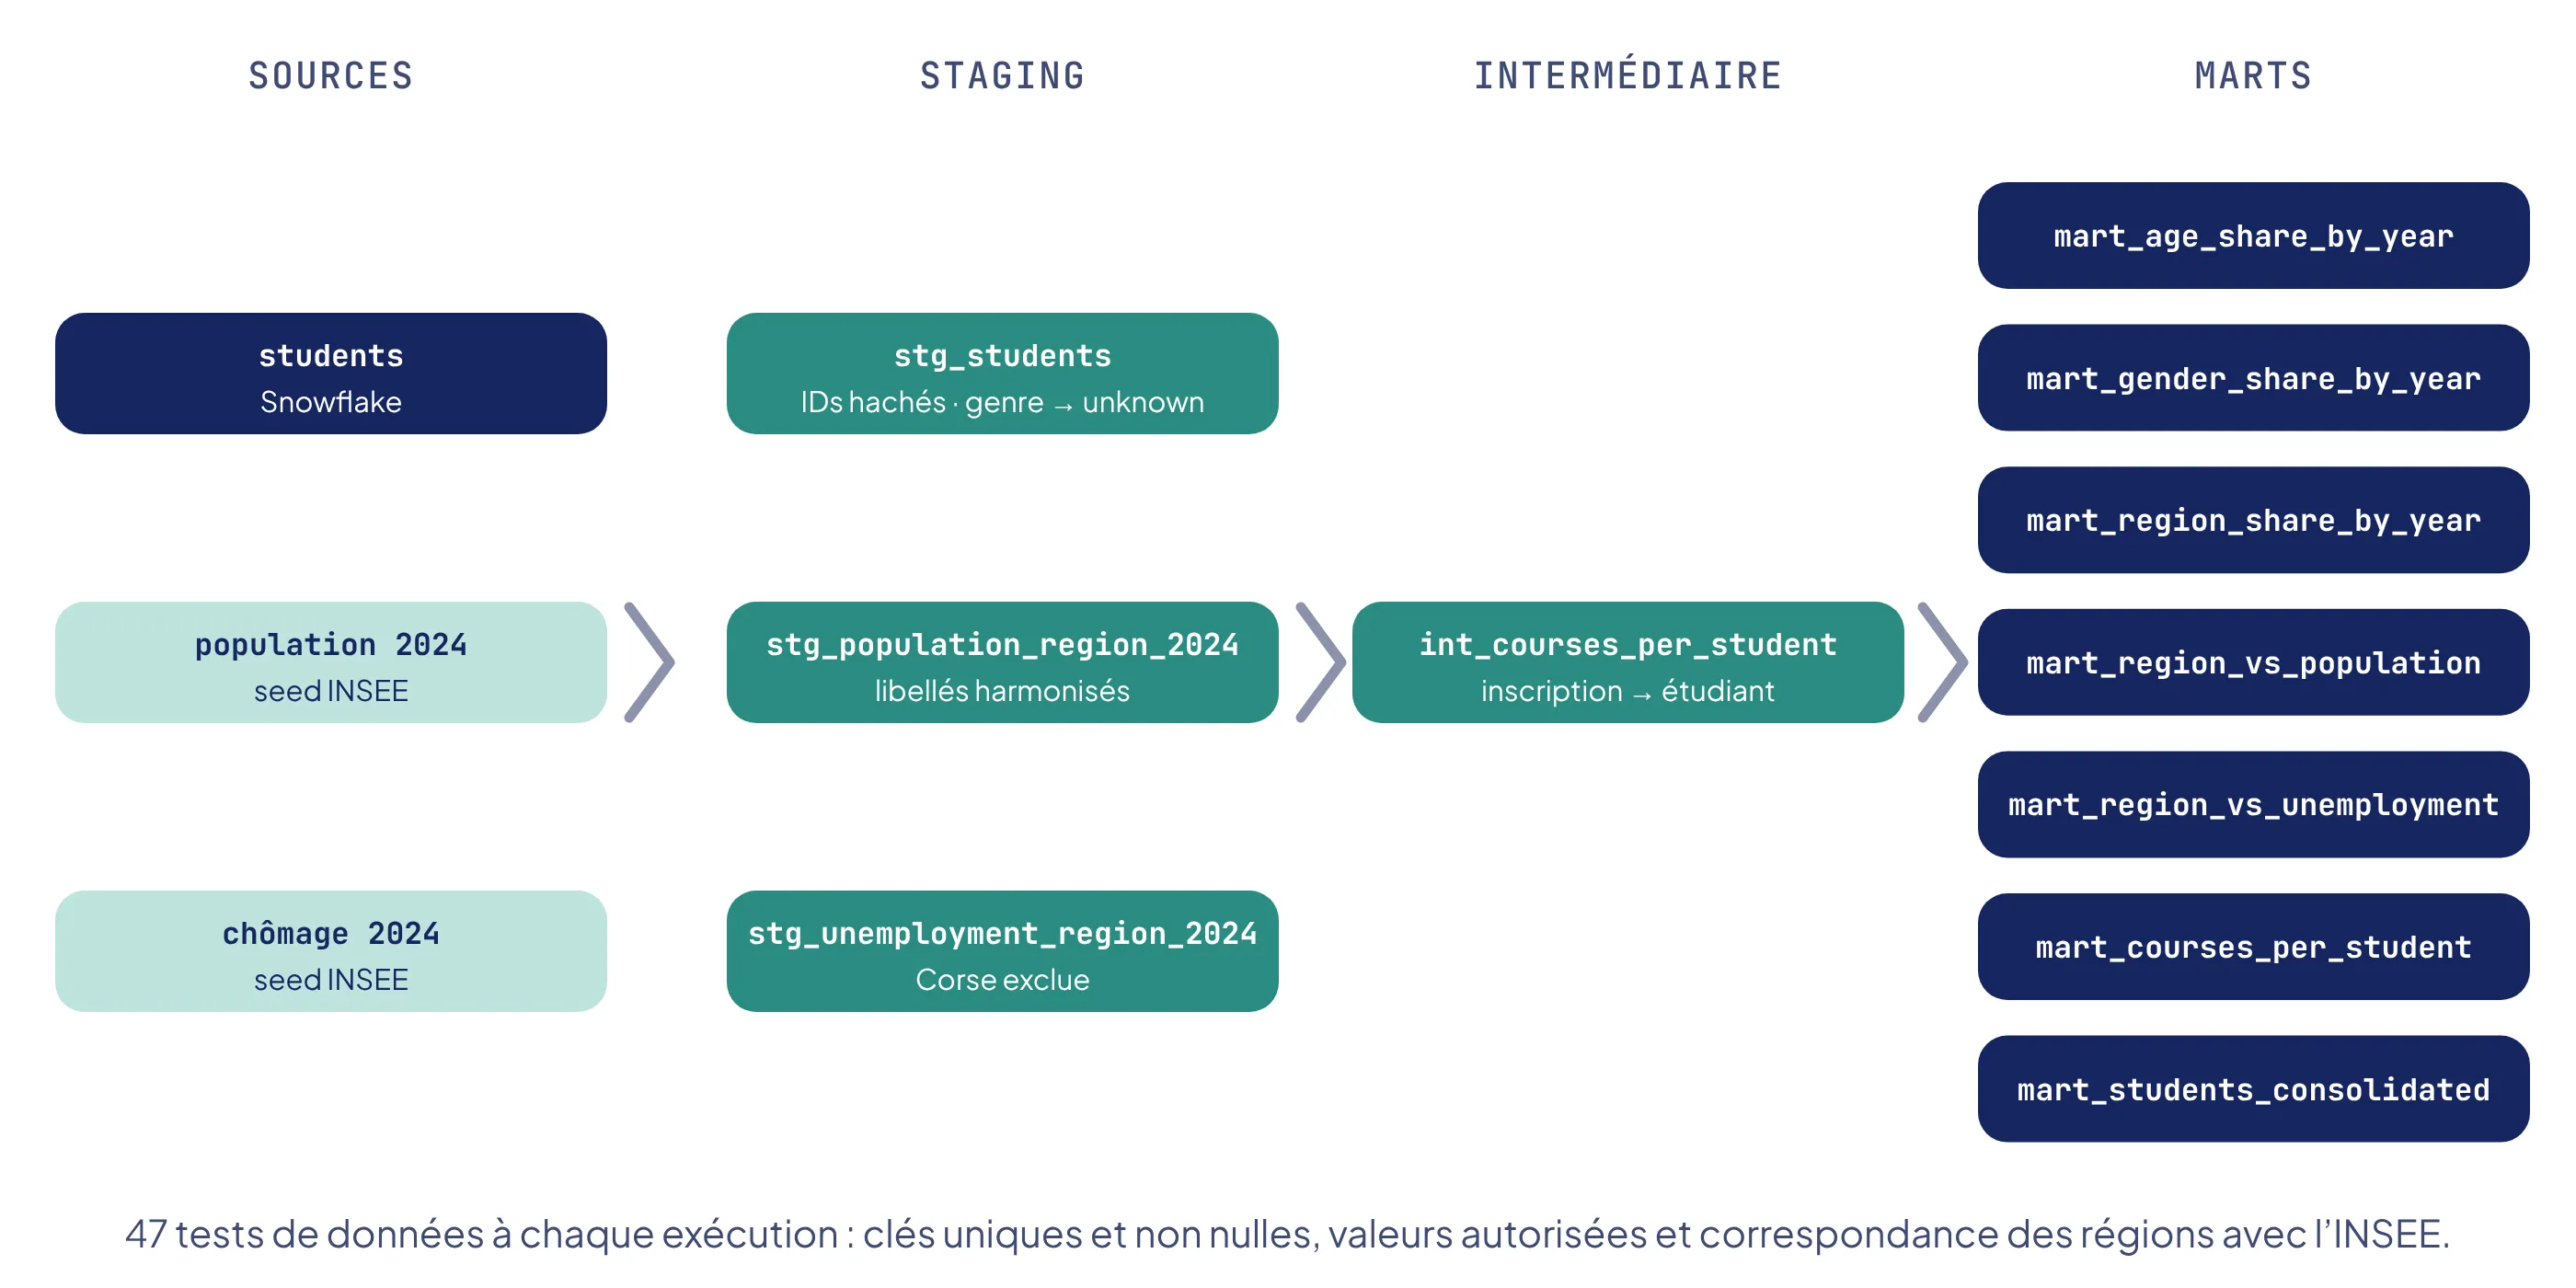
Cinq choix structurent l’ensemble du pipeline :
| Choix | Pourquoi |
|---|---|
| Identifiants hachés en SHA-256 dès le staging | RGPD : aucun identifiant brut ne dépasse la première couche. Il s’agit de pseudonymisation, pas d’anonymisation, car le lien reste théoriquement reconstituable côté source, et je le présente comme tel |
| Genres manquants conservés en « unknown » plutôt que supprimés | Les supprimer aurait masqué le taux de non-réponse, qui s’est révélé être l’un des constats clés |
| Libellés de régions harmonisés avec l’INSEE, départements d’outre-mer regroupés sous « DROM », Corse exclue | Sans libellés identiques, une jointure perd des lignes sans le signaler |
| Une seule année INSEE (2024) pour toute la période | Les parts régionales de population varient de moins de 0,15 point entre 2022 et 2025 : une seule année suffit, sans effet notable sur les comparaisons régionales |
| Tests à chaque exécution | Unicité et non-nullité des clés, valeurs autorisées pour chaque variable, et un test de relation qui vérifie que chaque région des étudiants existe dans le référentiel INSEE |
Ce dernier test est celui qui m’a le plus servi : il détecte toute divergence de libellé entre les données étudiantes et l’INSEE avant qu’elle ne fausse un résultat.
-- stg_students : pseudonymiser les identifiants et rendre explicites les genres manquants
select
    {{ hash_id("replace(user_id, '-', '')") }} as user_id_hash,
    {{ hash_id("replace(user_id, '-', '') || '_' || year_path_started") }} as primary_key,
    path_category_name as category,
    age_group,
    coalesce(gender, 'unknown') as gender,
    region,
    year_path_started as year_started
from {{ source('openclassrooms', 'students') }}
Des inscriptions en baisse
- 20221 696
- 20231 150
- 2024850
- 2025951
La complétude de 2025 reste à confirmer auprès de l’équipe de collecte.
Les inscriptions sont passées de 1 696 en 2022 à 850 en 2024, avant un rebond partiel à 951 en 2025 : soit une baisse nette de 44 %. Les données n’expliquent pas pourquoi : elles ne disent rien du marché de l’emploi ni du marketing. C’est un constat, pas un diagnostic. Mais si les données ne disent pas pourquoi moins d’étudiants s’inscrivent, elles montrent qui s’inscrit encore, et ce profil change.
Un public qui rajeunit
La part des moins de 35 ans est passée de 43 % des inscriptions en 2022 à 53 % en 2025 : ils sont devenus majoritaires. Toute cette croissance vient des plus jeunes : la part des 20–24 ans a été multipliée par sept, de 1,2 % à 8,5 %, et celle des 25–29 ans est passée de 15 % à 21 %. Toutes les tranches d’âge supérieures ont reculé.
Un parcours qui reste masculin, et un piège dans les données brutes
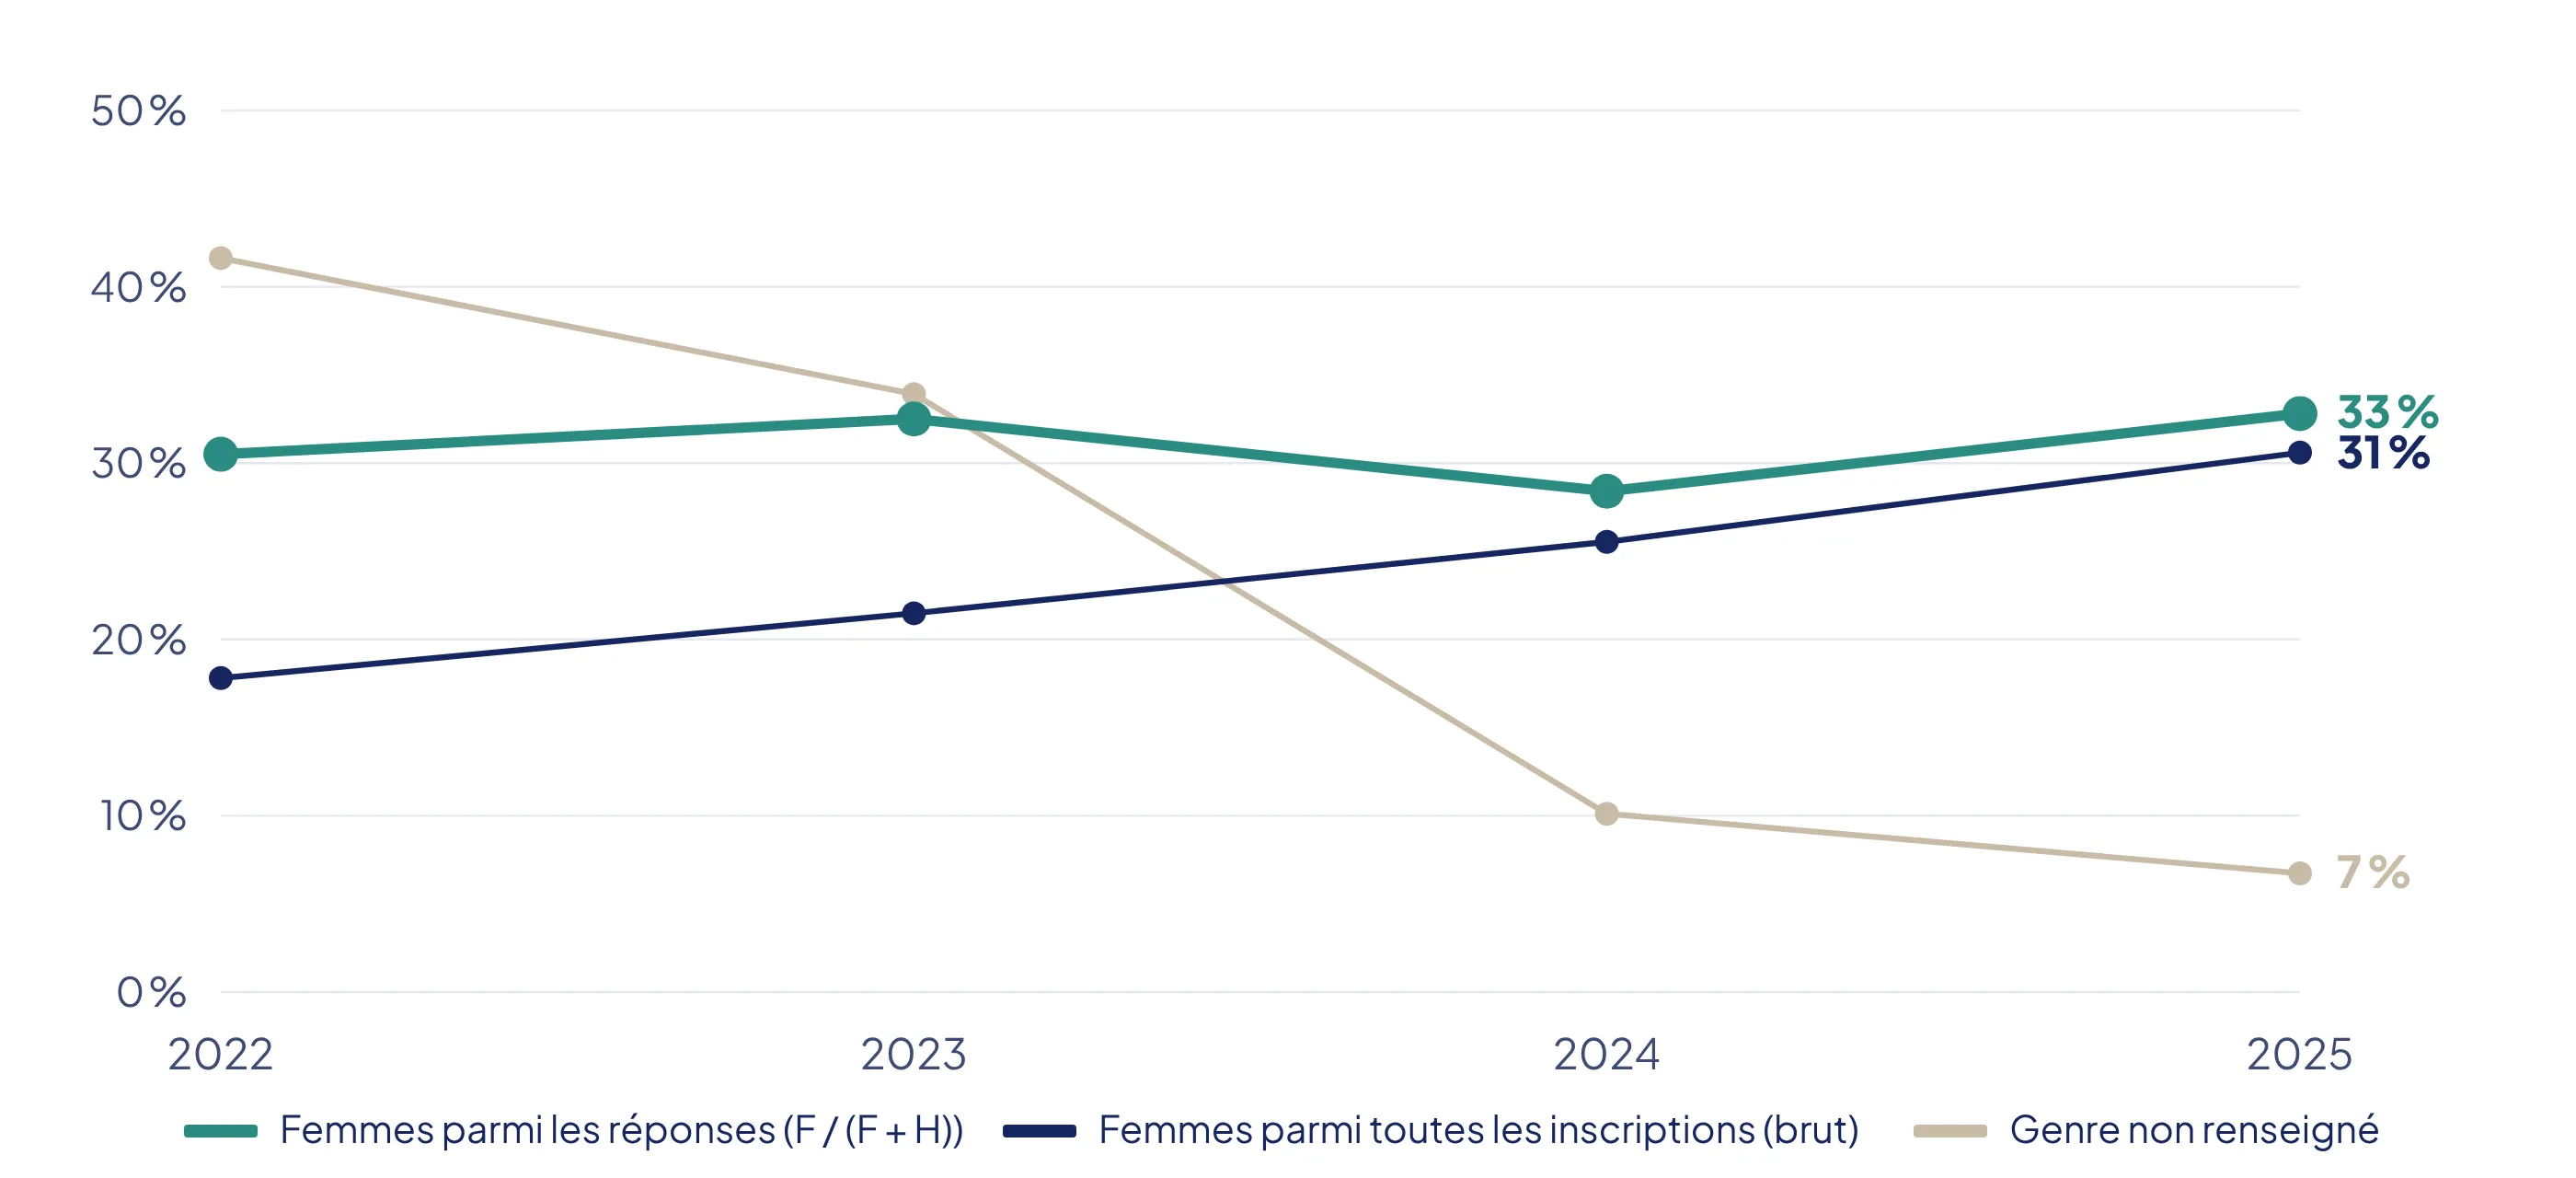
Dans les données brutes, la part des femmes semble grimper de 18 % à 31 %. C’est un artefact. En 2022, plus de quatre inscriptions sur dix n’avaient pas de genre renseigné ; en 2025, moins d’une sur quinze. Ce qui s’améliore réellement, c’est la collecte, pas la mixité. Mesurée uniquement parmi les étudiants ayant renseigné leur genre, qui constituent la base fiable, la part des femmes reste autour de 30 % chaque année. La baisse des inscriptions touche les hommes comme les femmes.
- 20–2418 %
- 25–2928 %
- 30–3433 %
- 35–3933 %
- 40–4437 %
- 45–4933 %
- 50–5430 %
- 55–5931 %
- 60+7 %
C’est l’enseignement clé de l’analyse. Le cœur des tranches d’âge est stable, entre 30 % et 37 % de femmes, mais la tranche la plus jeune tombe à 18 %. Or ce sont précisément les tranches les plus jeunes qui progressent. À mesure que le public rajeunit, la part globale des femmes baissera mécaniquement, à moins d’agir.
Aucune région n’approche non plus la parité, avec des taux compris entre 21 % et 36 %. L’Île-de-France, à 36 %, tire la moyenne nationale vers le haut ; ailleurs, elle tourne autour de 27 %. Les écarts régionaux reposent sur de faibles effectifs et ne sont pas interprétables individuellement : la mixité est un enjeu national pour la filière, pas un enjeu territorial.
Une forte concentration en Île-de-France
- Île-de-France2,49
- Provence-Alpes-Côte d’Azur0,83
- Auvergne-Rhône-Alpes0,78
- Hauts-de-France0,74
- Nouvelle-Aquitaine0,70
- Centre-Val de Loire0,69
- Occitanie0,68
- Grand Est0,68
- Bretagne0,59
- Pays de la Loire0,59
- Normandie0,50
- Bourgogne-Franche-Comté0,41
- Régions d’outre-mer (DROM)0,30
Parts calculées sur l’ensemble des inscriptions de 2022 à 2025. Un ratio de 1 signifie qu’une région pèse autant parmi les étudiants que dans la population.
L’Île-de-France représente 46 % des étudiants mais seulement 18 % de la population française, soit une surreprésentation d’un facteur 2,5. Douze régions sur treize sont en dessous de leur poids démographique. Pour une formation 100 % en ligne, c’est frappant : il n’y a aucune barrière géographique à lever, le sujet n’est donc pas l’accès mais la visibilité hors de la région parisienne.
Il pourrait sembler logique que les régions à fort chômage génèrent davantage d’inscriptions, par effet de reconversion. J’ai testé cette hypothèse : elle ne tient pas. Les Hauts-de-France ont le taux de chômage le plus élevé mais une présence moyenne, l’Île-de-France un taux de chômage moyen mais une présence record, et les Pays de la Loire le chômage le plus faible avec une présence faible elle aussi. Un indicateur à l’échelle d’une région entière ne dit rien de la situation individuelle des personnes qui s’inscrivent : pour comprendre qui s’inscrit et pourquoi, il faudrait des données individuelles, comme la catégorie socioprofessionnelle ou la situation au moment de l’inscription (en poste, en recherche d’emploi, étudiant).
Un public de passage
86 % des étudiants ne suivent qu’un seul parcours (3 442 sur 4 010) ; seuls 14 % reviennent pour en suivre un autre. Dans un contexte de baisse des inscriptions, l’activité repose donc presque entièrement sur l’acquisition de nouveaux étudiants, et la fidélisation devient un vrai enjeu : faire revenir une partie de ces 86 % apparaît comme un levier à explorer, potentiellement plus durable que le seul recrutement. Les cohortes récentes ont eu moins de temps pour revenir, ce taux est donc un plancher, mais il a peu de chances d’évoluer sensiblement de lui-même.
Recommandations
- Cibler les jeunes femmes dans le recrutement : c’est le groupe où l’écart est le plus grand et où le public progresse.
- Développer la visibilité hors Île-de-France, puisqu’une formation en ligne n’a pas de barrière géographique.
- Collecter le statut professionnel à l’inscription, pour comprendre qui s’inscrit et pourquoi.
- Continuer à fiabiliser la collecte du genre, déjà bien meilleure depuis 2022.
- Reproduire l’étude dans deux à trois ans, sur une base désormais homogène, en relançant le même pipeline.
Limites
- Les causes de la baisse ne sont pas dans les données : l’analyse décrit, elle n’explique pas.
- La complétude de 2025 reste à confirmer.
- Les écarts régionaux reposent sur de faibles effectifs pour plusieurs régions.
- Les régions d’outre-mer sont écartées de la comparaison avec le chômage : elles sont regroupées dans une seule catégorie DROM, et aucun taux de chômage unique ne peut représenter fidèlement cinq régions aussi différentes que la Martinique et Mayotte ; j’ai donc choisi de laisser ce groupe de côté.
Ce que j’en retiens
Un détail de méthode a changé toute la lecture du projet : conserver les genres manquants en « unknown » au lieu de les supprimer. C’est ce qui a montré que la hausse de la part des femmes venait surtout d’une baisse de la non-réponse. dbt m’a aussi appris à raisonner en couches et en tests : quand un chiffre semble faux, je sais quelle couche ouvrir, et le test sur les régions détecte une divergence de libellé avant qu’elle ne casse une jointure.